Seo Teknik Kontrol Listesi, Site Hızı ve Core Web Vitals
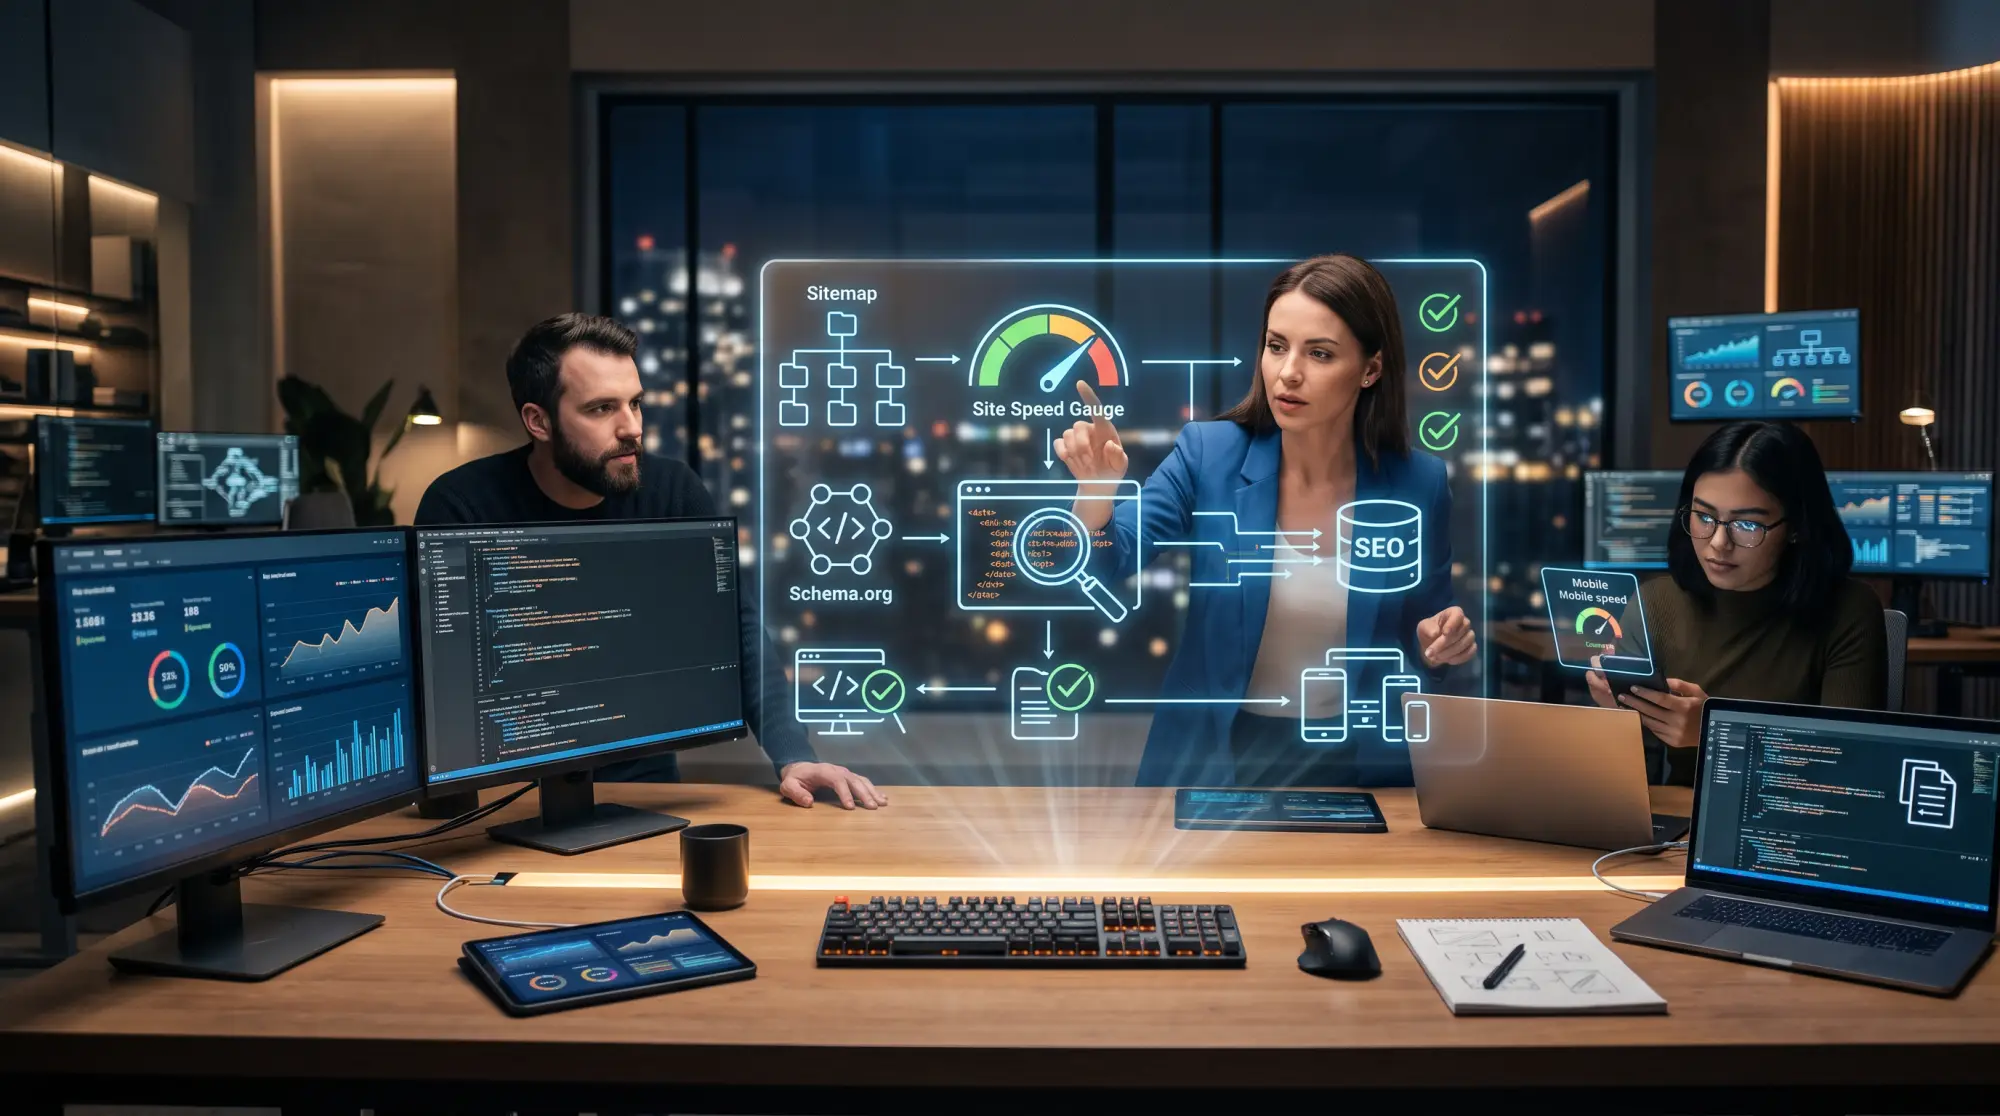
Bir sayfanın açılma süresi, kullanıcı deneyiminin yanında sıralamayı da etkiliyor. Google’ın Core Web Vitals ölçütleri burada devreye giriyor: LCP, INP ve CLS. Projelerimizde bu üç metriği ayrı ayrı inceliyoruz; biri düzelirken diğeri bozulabiliyor.
| Metrik | İyi Kabul Edilen Değer | İyileştirme Yöntemi |
|---|---|---|
| LCP | 2.5 saniyeden az | Görsel sıkıştırma, sunucu yanıt süresi, önbellekleme |
| INP | 200 milisaniyeden az | JavaScript yükünü azaltmak, ana iş parçacığını rahatlatmak |
| CLS | 0.1'den az | Görsellere sabit boyut vermek, reklam alanlarını önceden ayırmak |
Bu tabloyu tek seferlik ölçüm için değil, aylık takip için kullanıyoruz. Sunucu tarafında bir değişiklik yapıldığında ya da yeni bir eklenti kurulduğunda skorlar hızla bozulabiliyor. PageSpeed Insights ve Search Console’daki Core Web Vitals raporu bu değişimi yakalıyor.
Mobil Uyumluluk ve Mobil Öncelikli Dizinleme
Google artık sitelerin mobil sürümünü esas alarak dizinliyor. Masaüstünde kusursuz görünen bir sayfa, mobilde metin taşması ya da tıklanamayan buton sorunları yaşıyorsa bu durum sıralamaya yansıyor. Test ederken gerçek bir telefondan bakıyoruz; tarayıcı simülasyonları her zaman gerçek deneyimi vermiyor.
Dikkat ettiğimiz noktalardan biri viewport ayarı: meta viewport etiketi doğru tanımlanmadığında sayfa mobilde küçülmüş halde açılıyor. Bunun yanında dokunma hedeflerinin arasındaki boşluk, yazı boyutunun okunabilirliği ve mobil menünün gizlenip açılma hızı da kullanıcı deneyimini doğrudan etkiliyor.
Tarama Bütçesi ve robots.txt Yönetimi
Google botunun bir siteye ayırdığı zaman ve kaynak sınırsız değil. Küçük bir kurumsal site için bu genelde sorun çıkarmıyor. Ama binlerce sayfalı bir e-ticaret sitesinde tarama bütçesinin nereye gittiği önem kazanıyor. Filtre parametreleriyle oluşan gereksiz URL’ler, arama sonucu sayfaları ya da sepet adımları da bot tarafından taranabiliyor. Bunlar tarandığında asıl önemli sayfalara ayrılan zaman azalıyor.
robots.txt dosyasını bu yüzden düzenli kontrol ediyoruz. Yanlış yazılmış bir Disallow satırı, farkında olmadan tüm siteyi ya da kritik bir bölümü aramadan gizleyebiliyor. Bir projede canlıya alınan sürümde staging ortamından kalan “Disallow: /” satırının silinmediğini fark ettiğimizde site aylardır hiç taranmıyordu.
XML Sitemap Kurulumu
Site haritası, botlara “bunlar bizim önemli sayfalarımız” demenin en doğrudan yolu. Ancak burada sık yapılan bir hata var: sitemap içine 404 veren, yönlendirilmiş ya da noindex etiketi taşıyan sayfaların eklenmiş olması. Böyle çelişkili sinyaller gördüğünde Google haritadaki yönlendirmeleri dikkate almamaya başlıyor.
Sitemap dosyasını canlı tutmak için CMS’in otomatik oluşturduğu sürümü kullanıyoruz, elle güncellenen statik dosyalardan kaçınıyoruz. Search Console üzerinden gönderdikten sonra “Taranan ama işlenmedi” ya da “Alternatif sayfa, doğru canonical etiketi” gibi uyarıları düzenli kontrol ediyoruz. Bu uyarılar genelde teknik bir sorunun ilk işareti oluyor.
URL Yapısı ve Site Mimarisi
Uzun, parametre dolu ve okunması zor URL’ler kullanıcıyı da botu da yoruyor. Bir ürün sayfasının adresi site.com/urun?id=4821&kategori=12&ref=xyz şeklindeyse hem paylaşılabilirliği düşük hem de içerikle ilgili hiçbir sinyal taşımıyor. Bunun yerine anlamlı kelimeler içeren, kısa ve tutarlı bir yapı kuruyoruz: site.com/kategori/urun-adi.
Tıklama derinliğini de mimariyi kurarken doğrudan hesaba katıyoruz. Ana sayfadan üç tıklamayı geçen bir sayfaya bot ve kullanıcı zor ulaşıyor. Kategori sayfaları, iç bağlantılar ve menü yapısı bu derinliği kısaltmak için kullandığımız araçlar. Her yeni içerik eklerken onu en az bir üst kategoriden bağlantı vererek erişilebilir kılıyoruz.
HTTPS ve Karma İçerik Sorunları
SSL sertifikası artık standart bir gereklilik, fakat sertifika kurulduktan sonra da denetim bitmiyor. Sayfa içinde hâlâ http:// ile başlayan görsel, script ya da stil dosyası varsa tarayıcı bunu “karma içerik” olarak işaretliyor. Kilit simgesi de kırık görünüyor. Bu durum güven algısını zayıflatıyor.
Kontrol ederken tarayıcı konsolundaki uyarılara bakıyoruz, ayrıca site içi tarama araçlarıyla http bağlantılarını topluca tespit ediyoruz. Sertifika yenileme tarihini de takip listesine alıyoruz; otomatik yenileme kurulmadıysa süresi dolan sertifika bir gecede tüm siteyi erişilemez hale getirebiliyor.
Canonical Etiketler ve Yinelenen İçerik
Aynı içeriğe birden fazla URL üzerinden ulaşılabiliyorsa Google bunlardan hangisini asıl versiyon sayacağına kendi başına karar veriyor. Bu da her zaman istediğimiz sonucu vermiyor. Canonical etiketi tam olarak bu kararı bizim vermemizi sağlıyor.
E-ticaret sitelerinde renk ve beden parametreleriyle çoğalan ürün sayfaları bu sorunun en sık görüldüğü yerlerden biri. Blog sitelerinde ise etiket ve arşiv sayfaları da aynı sorunu yaşıyor. Her sayfanın kendi kendine canonical vermesi kural gibi görünüyor. Ama parametreli varyasyonlarda ana ürün sayfasına canonical vermek daha doğru sonuç veriyor. Yanlış kurulmuş bir canonical, sayfanın kendisini değil başka bir sayfayı işaret ettiğinde o sayfa dizinden tamamen düşebiliyor.
Yapılandırılmış Veri (Schema.org)
Arama sonuçlarında yıldızlı puan, tarif süresi, ürün fiyatı ya da sık sorulan sorular gibi ek bilgiler görünebiliyor. Bu görünüm yapılandırılmış veri sayesinde oluyor. Bu işaretleme sıralamayı doğrudan yükseltmiyor ama tıklama oranını artırıyor, çünkü sonuç diğerlerinden görsel olarak ayrışıyor.
| Sayfa Türü | Uygun Schema Türü | Görünür Kazanç |
|---|---|---|
| Ürün sayfası | Product | Fiyat, stok durumu, yıldız puanı |
| Blog yazısı | Article | Yazar, yayın tarihi |
| İşletme sayfası | LocalBusiness | Adres, çalışma saatleri |
| SSS bölümü | FAQPage | Açılır soru-cevap kutuları |
İşaretlemeyi ekledikten sonra Google’ın Zengin Sonuç Testi aracıyla doğruluyoruz. Sayfadaki görünen metinle schema içindeki veri örtüşmüyorsa Google bu işaretlemeyi yok sayabiliyor, hatta manuel işlem riski doğurabiliyor.
Yönlendirmeler ve Durum Kodları
Bir sayfa taşındığında ya da silindiğinde doğru HTTP durum kodunu vermek, hem kullanıcı deneyimi hem de sıralama için kritik. 301 yönlendirmesi kalıcı taşınmayı bildirirken, 302 geçici bir durumu işaret ediyor. Bu ikisinin karıştırılması Google’ın sayfaya verdiği değeri yanlış yere aktarmasına neden oluyor.
| Durum Kodu | Anlamı | Ne Zaman Kullanılır |
|---|---|---|
| 200 | Başarılı | Sayfa normal şekilde çalışıyor |
| 301 | Kalıcı yönlendirme | URL kalıcı olarak değişti |
| 302 | Geçici yönlendirme | Kısa süreli bakım ya da test |
| 404 | Bulunamadı | Sayfa gerçekten yok, kalıcı olarak kaldırıldı |
| 410 | Kalıcı olarak silindi | İçerik bilinçli olarak kaldırıldı, geri gelmeyecek |
Zincirleme yönlendirmeler de sıkça karşılaştığımız bir sorun. A sayfası B’ye, B sayfası C’ye yönlendiriyorsa her adım hem yükleme hızını düşürüyor hem de bot tarafında kafa karışıklığı yaratıyor. Yönlendirmeleri her zaman doğrudan hedefe bağlıyoruz, ara adımları temizliyoruz.
JavaScript Render Sorunları
Modern çatılarda içerik ekrana ancak JavaScript tarayıcı tarafında koştuktan sonra düşüyor. Google botu bu içeriği çalıştırıp okuyabiliyor, fakat bu işlem her zaman aynı hızda ve güvenilirlikte olmuyor. Kritik metinlerin ve bağlantıların yalnızca JavaScript render’ından sonra göründüğü durumlarda dizinleme geciken ya da hiç gerçekleşmeyen sayfalarla karşılaşıyoruz.
Bu riski azaltmak için sunucu tarafı render (SSR) ya da statik oluşturma (SSG) yaklaşımlarını tercih ediyoruz. Mevcut bir JavaScript uygulamasında bu dönüşüm mümkün değilse, en azından Google Search Console’daki URL denetim aracını kullanıyoruz. Bu araçla render sonucunun gerçek içerikle örtüştüğünü doğruluyoruz.
Hreflang ve Çok Dilli Siteler
Birden fazla dilde ya da bölgeye özel içerik sunan sitelerde hreflang etiketi hangi kullanıcıya hangi sayfanın gösterileceğini belirliyor. Bu etiket eksik ya da hatalı kurulduğunda Türkiye’deki bir kullanıcıya İngilizce sayfa, İngilizce arayan kullanıcıya Türkçe sayfa gösterilebiliyor.
Her dil sürümünün birbirine karşılıklı referans vermesi gerekiyor. Yani A dilindeki sayfa B dilindeki sayfayı işaret ederken B dilindeki sayfa da A’yı işaret etmeli. Bu karşılıklılık kurulmadığında Google etiketi görmezden geliyor. x-default değerini de her zaman ekliyoruz, çünkü eşleşen bir dil bulunamadığında kullanıcının hangi sayfaya yönlendirileceğini bu belirliyor.
Sayfalama ve İçerik Bölünmesi
Uzun ürün listeleri ya da blog arşivleri birden fazla sayfaya bölündüğünde her sayfanın kendine ait, benzersiz bir URL taşıması gerekiyor. Sonsuz kaydırma (infinite scroll) kullanılan sitelerde botun ikinci ve sonraki sayfalara ulaşabilmesi için ayrıca statik bir sayfalama linki bırakıyoruz. Aksi halde bot yalnızca ilk yüklenen içeriği görüyor.
Sayfalanmış içerikte her sayfaya kendi başına canonical vermek, birinci sayfaya toplu canonical vermekten daha doğru sonuç veriyor. Çünkü ikinci sayfadaki ürünler birinci sayfada yer almıyor, dolayısıyla bu iki sayfa aslında farklı içerik taşıyor.
Görsel ve Medya Optimizasyonu
Sayfa yükünü genelde görseller sırtlar; optimize edilmediklerinde de ilk darbeyi hız alır. Sıkıştırma formatı olarak WebP ya da AVIF kullanmak, aynı görsel kalitesini çok daha küçük dosya boyutuyla sunuyor.
Alt metni doldururken görseli tarif eden, anahtar kelime doldurmasından uzak bir cümle yazıyoruz. Bu metin görme engelli kullanıcılar için ekran okuyucular tarafından okunuyor, ayrıca Google Görseller trafiğinde de belirleyici oluyor. Lazy loading uyguladığımızda ise sayfanın ilk ekranda görünen (above the fold) görsellerini bu özellikten hariç tutuyoruz. Çünkü onların gecikmeli yüklenmesi LCP skorunu doğrudan bozuyor.
Log Dosyası Analizi
Search Console verisi Google’ın bize gösterdiği özet bilgiyi sunuyor. Ama sunucu log dosyaları botun sitede gerçekte ne yaptığını, hangi sayfaları ne sıklıkla ziyaret ettiğini ham veri olarak gösteriyor. Büyük ölçekli sitelerde bu analiz, tarama bütçesinin nereye harcandığını gerçek anlamda görmenin tek yolu.
Log incelemesinde en çok dikkat ettiğimiz nokta, botun düşük değerli sayfalarda (filtre kombinasyonları, arama sonuçları) ne kadar zaman geçirdiği. Bu sayfaları noindex ya da robots.txt ile kapattığımızda botun asıl önemli sayfalara ayırdığı zaman gözle görülür şekilde artıyor.
Düzenli Denetim Takvimi
| Kontrol | Sıklık | Kullanılan Araç |
|---|---|---|
| Core Web Vitals | Aylık | PageSpeed Insights, Search Console |
| Kırık bağlantı ve 404 taraması | Aylık | Screaming Frog, Ahrefs |
| Sitemap ve robots.txt doğrulama | Her yayın sonrası | Search Console |
| Log dosyası analizi | Üç aylık | Sunucu log araçları |
| Yapılandırılmış veri doğrulama | Her şema güncellemesinde | Zengin Sonuç Testi |
Bu takvimi bir kontrol listesi olarak değil, canlı bir rutin olarak görüyoruz. Bir sorunu tek seferde çözmek yerine, aynı hatanın tekrar oluşup oluşmadığını her döngüde yeniden kontrol ediyoruz. Teknik SEO’da asıl kazanç da buradan geliyor.
İç Linkleme ve Sayfa Derinliği Sorunları
Bir sayfaya ana sayfadan kaç tık ile ulaşılıyorsa, o sayfanın “tıklama derinliği” o kadardır. Ana sayfadan 5-6 tık ötede kalan ürün sayfalarını Google çoğu zaman hiç taramıyor, taradığında da düşük öncelikli görüyor. E-ticaret projelerimizde bu sorunu sık görüyoruz. Kategori > alt kategori > alt kategori > ürün listesi > ürün detayı şeklinde uzayan bir hiyerarşi var. Bu hiyerarşi, binlerce ürünü aramanın erişemeyeceği bir derinliğe gömüyor.
Çözüm genelde teknik değil, mimari. Kategori sayfalarına “en çok satanlar” veya “yeni gelenler” gibi dinamik bloklar ekleyerek derin sayfalara ana sayfaya yakın noktalardan bağlantı açıyoruz. Bir projede ürün derinliğini 6 tıktan 3 tıka indirdik. O ürün grubundaki organik gösterim sayısı üç ay içinde iki kattan fazla arttı.
İç linkleme yaparken anchor metnini de kontrol ediyoruz. “Buraya tıklayın” gibi genel ifadeler yerine hedef sayfanın konusunu yansıtan metinler kullanıyoruz. Bu, Google’a o sayfanın neyle ilgili olduğu konusunda ek sinyal veriyor. Bir sayfaya giden tüm iç bağlantıların anchor metnini Screaming Frog ile çıkarıp, hangi sayfaların hâlâ genel ifadelerle bağlandığını listeliyoruz.
Kırık Bağlantı ve 404 Sayfası Yönetimi
Kırık bağlantı denince akla dışarıya giden linkler gelir, ama asıl kayıp genelde site içinde oluyor. Bir ürün kaldırıldığında, o ürüne dair diğer sayfalardaki iç bağlantılar 404 vermeye başlıyor. Bot bu döngüye girdiğinde tarama bütçesinin bir kısmını boş sayfalara harcıyor.
Aylık taramalarımızda 404 listesini üç grupta değerlendiriyoruz:
| 404 Türü | Yapılan İşlem |
|---|---|
| Ürün kalıcı olarak kaldırıldı | 301 ile ilgili kategoriye yönlendirme |
| Yazım hatası ya da eski URL kalıntısı | 301 ile doğru sayfaya yönlendirme |
| Gerçekten silinmesi gereken sayfa | 410 durum kodu, iç bağlantıları temizleme |
410 durum kodunu bilerek kullanıyoruz; çünkü 404 Google'a "belki geri gelir" mesajı veriyor. 410 ise "kalıcı olarak gitti" der ve botun o sayfayı tarama listesinden daha hızlı çıkarmasını sağlıyor. Sürekli 404 üreten bir site yapısında bu ayrımı yapmadan sadece yönlendirme eklemek, aslında çözülmesi gereken kök sorunu gizliyor.
Sunucu Yanıt Süresi ve TTFB Optimizasyonu
Time to First Byte, tarayıcının sunucudan ilk baytı alma süresi. Bu rakam 200 milisaniyenin üzerine çıktığında hem kullanıcı deneyimi hem de Core Web Vitals ölçümleri kötüleşiyor. LCP hesaplamasının başlangıç noktası zaten TTFB olduğu için, sunucu yavaşsa geri kalan her optimizasyon boşa gidiyor.
TTFB'yi yükselten üç sebeple sık karşılaşıyoruz: paylaşımlı hosting üzerinde çalışan yoğun bir veritabanı sorgusu ve önbelleğe alınmamış dinamik sayfa üretimi. Üçüncü sebep ise coğrafi olarak kullanıcıdan uzak sunucu konumu. Bir sağlık turizmi projesinde sunucuyu paylaşımlı hostingten VPS'e taşıdığımızda TTFB 620 milisaniyeden 140 milisaniyeye düştü. Bu da LCP skorunu 1,2 saniye iyileştirdi.
Veritabanı tarafında ise yavaş sorguları tespit etmek için sunucu loglarındaki "slow query" kayıtlarını inceliyoruz. Sık çalışan ama nadiren değişen sorguları (kategori listeleri, menü verisi gibi) sayfa önbelleğine alıyoruz. Bu, sunucuyu her istekte yeniden hesaplama yapmaktan kurtarıyor.
Faceted Navigation ve Filtre Sayfaları
E-ticaret sitelerinde renk, beden, fiyat aralığı gibi filtreler her kombinasyon için ayrı bir URL üretebiliyor. Yüz ürünlük bir kategori, on filtre seçeneğiyle binlerce URL kombinasyonuna dönüşebiliyor. Bunların hiçbiri gerçek bir içerik farkı taşımıyor. Ama bot her birini ayrı sayfa sanıp taramaya çalışıyor.
Bir müşterimizin sitesinde bu sorunu Search Console'daki "taranan ama dizine eklenmedi" raporunda fark ettik. 40.000'in üzerinde filtre URL'si taranıyor, tarama bütçesinin büyük kısmı buraya gidiyordu. Çözüm için filtre parametrelerini canonical etiketle ana kategori sayfasına yönlendirdik, ayrıca bu parametreleri robots.txt'te ayrı bir kural satırıyla kapattık.
Burada dikkat edilmesi gereken nokta, gerçekten arama hacmi olan filtre kombinasyonlarını bu kısıtlamanın dışında tutmak. Örneğin "erkek spor ayakkabı 42 numara" gibi kombinasyonlar buna dahildir. Bu tür sayfaları statik URL'ye çevirip kendi başlık ve açıklamasıyla indekslenebilir hale getiriyoruz. Böylece hem tarama bütçesi tasarrufu sağlıyoruz hem de gerçek trafik potansiyeli olan sayfaları kaybetmiyoruz.
Yapay Zekâ Botları ve Güncel robots.txt Kuralları
Son iki yılda robots.txt dosyasına eklenen kural sayısı arttı. GPTBot, Google-Extended, CCBot gibi yapay zekâ eğitim botları artık ayrı user-agent satırlarıyla yönetiliyor. Bir site bu botları tamamen engellemek isteyebilir, bir başkası içeriğinin yapay zekâ modellerinde referans olarak geçmesini tercih edebilir. Bu karar teknik değil, ticari bir tercih.
Projelerimizde bu kararı müşteriyle birlikte alıyoruz. Örneğin özgün araştırma içeriği üreten bir müşterimiz GPTBot’u tamamen engellemeyi seçti, çünkü kendi verisinin başka platformlarda özetlenmesini istemedi:
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Bu satırların normal Googlebot taramasını etkilemediğini ayrıca test ediyoruz. Çünkü bazı sitelerde yanlış yazılan bir kural, istemeden ana botu da kapsıyor. Bu durumda organik trafik bir gecede sıfırlanabiliyor. Her robots.txt güncellemesinden sonra Search Console'daki "robots.txt Test Aracı" ile ana sayfaları ve örnek ürün sayfalarını tek tek kontrol ediyoruz.
Site Taşıma ve Domain Değişikliği Süreçleri
Domain değişikliği ya da platform taşıma, teknik SEO'da en riskli işlem. Bir e-ticaret sitesini eski altyapıdan yeni bir sisteme taşırken URL yapısı değişebiliyor. Doğru yönlendirme haritası çıkarılmadan yapılan geçişler trafiğin yarısını kalıcı olarak kaybettirebiliyor.
Taşıma öncesi çıkardığımız kontrol adımları şöyle:
- Eski sitenin tüm URL’lerini Screaming Frog ile tam listeleme
- Her eski URL’nin hangi yeni URL’ye karşılık geldiğini gösteren yönlendirme tablosu hazırlama
- 301 yönlendirmelerini canlıya almadan test ortamında doğrulama
- Taşıma günü eski ve yeni sitemap’i eş zamanlı Search Console’a bildirme
- İlk iki hafta günlük olarak dizine eklenme ve tıklama grafiklerini izleme
Bir sağlık kurumunun sitesini bu adımlarla taşıdığımızda, geçişten sonraki ilk hafta organik trafikte yalnızca %4 dalgalanma gördük. Oysa aynı büyüklükte planlanmamış bir taşımada bu kayıp genelde %30'un üzerine çıkıyor. Yönlendirme tablosundaki her satırı canlıya almadan önce elle kontrol etmek, işlemin en yavaş ama en kritik adımı.
Kod Şişkinliği ve Kaynak Sayısı Azaltma
Bir sayfanın kaç tane CSS, JavaScript ve font dosyası çağırdığı, sayfa hızını doğrudan etkiliyor. WordPress temelli sitelerde eklenti sayısı arttıkça her eklentinin kendi stil ve komut dosyasını sayfaya eklemesi, isteği sayısını hızla büyütüyor. Bir müşterimizin sitesinde 40’ın üzerinde eklenti aktifti ve tek bir sayfa 90’dan fazla ayrı dosya istiyordu.
Bu dosyaları teker teker açıp hangisinin gerçekten kullanıldığını Chrome DevTools'un "Coverage" sekmesiyle kontrol ettik. Sayfada hiç çalışmayan CSS'in yüzde 60'ının, JavaScript'in ise yüzde 45'inin gereksiz yüklendiğini gördük. Kullanılmayan eklentileri kaldırıp kalanların dosyalarını birleştirdiğimizde toplam istek sayısı 90'dan 34'e düştü, sayfa yükleme süresi 4,1 saniyeden 1,8 saniyeye indi.
Font dosyaları da genelde göz ardı ediliyor. Bir site dört farklı font ağırlığını (light, regular, medium, bold) aynı anda yükleyebiliyor. Bu durumda her ağırlık için ayrı bir dosya indirmek zorunda kalıyor. Gerçekte kullanılan iki ağırlığı bırakıp diğerlerini kaldırmak, hem indirme boyutunu azaltıyor hem de render engelleyen kaynak sayısını düşürüyor.
CDN ve Önbellekleme Stratejileri
Bir sunucuya her istek geldiğinde dosyayı sıfırdan üretmek, özellikle trafiği yüksek sitelerde sunucuyu gereksiz yere zorluyor. İçerik dağıtım ağı (CDN) kullanmadan çalışan bir e-ticaret sitesinde, İstanbul’daki sunucudan Almanya’daki bir kullanıcıya dosya ulaşana kadar 380 milisaniye geçiyordu. CDN devreye alındıktan sonra aynı istek, kullanıcıya en yakın sunucudan (Frankfurt) karşılandığı için 90 milisaniyeye düştü.
Önbellekleme başlıklarını doğru ayarlamak CDN’den bağımsız bir konu. Cache-Control ve Expires başlıkları tarayıcıya “bu dosyayı ne kadar süre yeniden indirmeden kullanabilirsin” bilgisini veriyor. Statik dosyalarda (logo, ikon, değişmeyen CSS) bu süreyi kısa tutmak, sunucuya aynı dosya için tekrar tekrar istek göndermek anlamına geliyor.
| Dosya türü | Önerilen önbellek süresi | Gerekçe |
|---|---|---|
| Logo, favicon | 1 yıl | Neredeyse hiç değişmiyor |
| CSS/JS (versiyonlu) | 1 yıl | Dosya adı değiştiğinde otomatik güncellenir |
| Ürün görselleri | 1 ay | Stok güncellemelerinde değişebilir |
| HTML sayfaları | 0 - kısa süre | İçerik sık değişir |
Versiyonlama yapılmadan uzun önbellek süresi vermek riskli. CSS dosyasını güncelleyip yayına aldığımızda, dosya adı aynı kaldığı için tarayıcı hâlâ eski sürümü kullanıyor; kullanıcı bozuk bir sayfa görüyor. Dosya adına style.css?v=2 gibi bir sürüm parametresi eklemek bu sorunu çözüyor.
Orphan Sayfalar ve Crawl Anomalileri
Sahipsiz sayfa (orphan page), sitede fiilen var olan ama hiçbir iç linkten erişilemeyen sayfa demek. Google bu sayfayı genelde XML sitemap'ten ya da eski bir geri bağlantıdan bulup dizine ekliyor. Kullanıcı ise sitede gezinerek asla o sayfaya ulaşamıyor. Bir emlak sitesinde 1.200 ilan sayfası, filtre sisteminin değişmesiyle iç linklerden koptu ve sitemap'te kaldı. Google bu sayfaları dizinde tutmaya devam etti ama tıklama oranı sıfıra düştü. Kullanıcı deneyimi açısından değeri kalmayan bu sayfalar aynı zamanda tarama bütçesini de tüketiyordu.
Search Console'daki "Kapsam" raporunda görülen "Soft 404" hatası da benzer bir anomali. Sunucu 200 durum kodu döndürüyor ama sayfa içeriği boş ya da "ürün bulunamadı" mesajı içeriyor. Google bunu gerçek bir hata sayfası olarak algılıyor. Stok tükenen ürünlerde bu hatayla sık karşılaşıyoruz: ürün kaldırılmış ama sayfa hâlâ 200 döndürüyor, içerikte tek satır "stokta yok" yazıyor. Doğru çözüm, ürün gerçekten geri gelmeyecekse sayfayı 410 durum koduyla kapatmak ya da benzer ürüne 301 ile yönlendirmek.
Orphan sayfaları bulmak için tarayıcı araçlarından (Screaming Frog gibi) çıkan liste ile sitemap’teki URL listesini karşılaştırıyoruz. Sitemap’te olup tarayıcının iç link takibiyle hiç ulaşamadığı her URL, potansiyel bir sahipsiz sayfa. Bu listeyi çıkardıktan sonra sayfayı ya bir kategoriye bağlıyoruz ya da kalıcı olarak kaldırıyoruz.
Alan Adı Yapısı: Alt Dizin, Alt Alan Adı ve Uluslararası Hedefleme
Blog, mağaza ya da yardım merkezi gibi bir bölümü ana siteden ayrı bir alt alan adında (blog.site.com) mı barındıracağız? Yoksa alt dizinde (site.com/blog) mi barındıracağımız sorusu her projede tekrar geliyor. Alt alan adı Google tarafından çoğu zaman ayrı bir site gibi değerlendiriliyor; ana domainin biriktirdiği otorite bu bölüme otomatik geçmiyor. Bir müşterimizin blog içeriğini alt alan adından alt dizine taşıdığımızda, altı ay içinde blog trafiği %65 arttı. Aynı içerik, aynı yazarlar, tek fark URL yapısıydı.
| Yapı | Otorite paylaşımı | Teknik izolasyon | Ne zaman tercih edilir |
|---|---|---|---|
| Alt dizin (site.com/blog) | Güçlü, doğrudan paylaşılır | Düşük | İçerik ana markayla bütünse |
| Alt alan adı (blog.site.com) | Zayıf, kısmen paylaşılır | Yüksek | Farklı altyapı/teknoloji gerekiyorsa |
| Ayrı domain | Yok | Tam | Bağımsız bir marka kuruluyorsa |
Uluslararası hedeflemede de benzer bir karar gerekiyor. Ülkeye özel alan adı (ccTLD, örneğin site.de) o ülkede güçlü bir sinyal veriyor. Ama her ülke için ayrı bir otorite biriktirmek gerekiyor. Alt dizin üzerinden dil hedeflemesi (site.com/de/) ise tek domainin otoritesini bütün dillere yayıyor. Sağlık turizmi projelerimizde çoğunlukla alt dizin ve hreflang kombinasyonunu tercih ediyoruz. Tek domain üzerinde büyüyen otorite, yeni açılan her dil sürümüne de yansıyor.
Üçüncü Taraf Betikler ve Etiket Yöneticisi Yönetimi
Google Etiket Yöneticisi (Google Tag Manager) üzerinden eklenen her yeni takip kodu, sayfaya ekstra bir JavaScript dosyası daha yükletiyor. Bir müşteri hesabında GTM içinde 23 farklı etiket aktifti. Bunlar arasında üç ayrı ısı haritası aracı, iki farklı reklam pikseli vardı. Ayrıca eski bir A/B test aracı ve kullanılmayan bir sohbet eklentisi de bulunuyordu. Bu etiketlerin toplam boyutu, sitenin kendi JavaScript'inden daha büyüktü.
Her etiketi tek tek denetleyip hangisinin hâlâ veri ürettiğini kontrol ettik. Kullanılmayan A/B test aracı ve sohbet eklentisini kaldırdık. Bunun sonucunda ana iş parçacığını bloke eden (main thread blocking) süre 1,2 saniyeden 0,4 saniyeye düştü. Etiketleri tetikleyici bazında düzenlemek de fark yaratıyor. Bir etiketin her sayfada değil, sadece ilgili sayfa grubunda çalışacak şekilde tetiklenmesi gereksiz yüklemeyi engelliyor.
Üçüncü taraf betiklerin bir kısmı kendi sunucumuzda barındırılamıyor. Bu durumda defer ya da async özelliğiyle bu dosyaların sayfa render işlemini bloke etmesini önlüyoruz. Özellikle sayfanın ilk görünür alanında (above the fold) hiçbir işlevi olmayan üçüncü taraf kodları var. Bu kodları sayfanın en altına ya da kullanıcı etkileşimi sonrasına taşımak gerekiyor. Bu taşıma, Core Web Vitals ölçümlerinde doğrudan iyileşme sağlıyor.
Sıkça sorulan sorular
- Core Web Vitals değerleri kaç olmalı?
- Core Web Vitals için LCP 2,5 saniyeden az, INP 200 milisaniyeden az olmalıdır. CLS değeri 0,1’in altında kalmalıdır. Biz bu üç metriği ayrı ayrı inceliyoruz. Görsel sıkıştırma, önbellekleme ve sunucu yanıt süresini değerlendiriyoruz. Takibi tek ölçümle bırakmıyor, aylık olarak sürdürüyoruz.
- Mobil uyumluluk SEO açısından nasıl kontrol edilir?
- Google, siteleri mobil sürümlerini esas alarak dizinler. Biz testleri gerçek telefonlarda yapıyoruz. Metin taşması, tıklanamayan butonlar ve okunabilir yazı boyutunu kontrol ediyoruz. Meta viewport etiketi doğru tanımlanmalıdır. Mobil menünün açılma hızı ve dokunma hedefleri arasındaki boşluk da incelenmelidir.
- Robots.txt dosyasında hangi hatalar kontrol edilmeli?
- Robots.txt içindeki yanlış bir Disallow satırı, tüm siteyi veya kritik bölümleri aramadan gizleyebilir. Biz dosyayı düzenli kontrol ediyoruz. Filtre parametreleri, arama sonuçları ve sepet adımlarının gereksiz taranmasını önlemeye çalışıyoruz. Binlerce sayfalı e-ticaret sitelerinde tarama bütçesini özellikle izliyoruz.
- Canonical etiketi hangi durumda kullanılmalı?
- Canonical etiketi, aynı içeriğe birden fazla URL üzerinden ulaşıldığında asıl sayfayı belirtir. Biz renk ve beden parametreleriyle çoğalan ürünlerde ana ürün sayfasını işaretliyoruz. Blog etiketleri ve arşiv sayfalarında da kontrol yapıyoruz. Yanlış canonical, doğru sayfanın dizinden düşmesine yol açabilir.
- 301 ve 302 yönlendirmesi arasındaki fark nedir?
- 301 yönlendirmesi, URL’nin kalıcı olarak değiştiğini gösterir. 302 yönlendirmesi, kısa süreli bakım veya test gibi geçici durumlarda kullanılır. Biz yönlendirmeleri doğrudan hedefe bağlıyoruz. A’dan B’ye, B’den C’ye uzanan zincirleri temizliyoruz. Böylece yükleme hızındaki ve bot tarafındaki gereksiz karmaşayı azaltıyoruz.
Kaynakça
- Web Vitals — Chrome for Developers — LCP, INP ve CLS metriklerinin eşik değerleri, tanımları ve optimizasyon kriterleri için resmî teknik dayanak sağlar.
- Google Search Central: Mobil Öncelikli Dizin Oluşturmaya İlişkin En İyi Uygulamalar — Mobil öncelikli dizinleme, viewport ayarları ve mobil kullanıcı deneyimi yönergeleri için resmî dokümantasyondur.
- Google Search Central: robots.txt Giriş ve Yönergeleri — Tarama bütçesi yönetimi, robots.txt kuralları ve bot erişim kısıtlamaları için resmî kaynaktır.
- Google Search Central: Site Haritaları Hakkında — XML sitemap dosya standartları ve arama botlarına doğru sayfaların iletilmesi kurallarına dayanak oluşturur.
- Google Search Central: Standartlaştırılmış (Canonical) URL'leri Belirtme — Yinelenen içeriklerin çözümü ve rel=canonical etiketinin doğru kullanımına kaynak teşkil eder.
- Schema.org Dokümantasyonu — Product, Article, LocalBusiness ve FAQPage yapılandırılmış veri şablonlarının teknik standardını belirler.
- Google Search Central: Çok Dilli ve Çok Bölgeli Siteleri Yönetme (hreflang) — Çok dilli sitelerdeki çift yönlü hreflang eşleşmeleri ve x-default kurallarını doğrular.
- Google Search Central: JavaScript SEO Temelleri — İstemci ve sunucu taraflı (SSR) JavaScript işleme ile botların render süreçleri için resmî kılavuzdur.