llms.txt nedir sorusunun kısa cevabı şöyle: sitenin kökünde duran, yapay zekâ araçlarına sitenin özetini sunan bir Markdown dosyası. Kimin önerdiğini, biçimini ve robots.txt ile site haritasından farkını aşağıda anlatıyoruz. Büyük şirketlerin resmi tutumunu yalnızca kendi açıklamalarından aktarıyoruz. Dosyayı okuyan botların sunucu günlüğünden nasıl sayılacağını ve Next.js'te otomatik üretimi de gösteriyoruz. Kendi sitemizin 15 günlük günlük kaydı da cevabın parçası.
llms.txt nedir, kim önerdi?
llms.txt, bir sitenin ne anlattığını ve en önemli bağlantılarını dil modellerine düz metinle tanıtan bir dosyadır. Öneriyi Jeremy Howard, 3 Eylül 2024'te Answer.AI adına yayımladı. Resmi bir standart değil, açık bir öneridir.
Önerinin çıkış noktası basit. Bir web sayfası insan için hazırlanır; menü, reklam ve JavaScript bilgiyi sarar. Bunu temiz metne çevirmek zordur ve sonuç her zaman doğru çıkmaz. Dil modellerinin bağlam penceresi de bütün bir siteyi almaya yetmez.
Öneri 10 Ağustos 2026'da ikinci sürümüne güncellendi. Metne göre dosyanın asıl kullanım anı eğitim değil, çıkarım anıdır. Yani bir ajan kullanıcıya yardım ederken o konuda bilgi aradığında dosyayı okur. Kodlama ajanının bir kütüphanenin belgesine bakması tipik örnektir.
OpenAI, Anthropic ve Google kendi geliştirici belgeleri için llms.txt yayımlıyor. Next.js belgelerinin de bir llms.txt dosyası var. Yalnız bir dosyayı yayımlamak, tarayıcıların onu okuduğu anlamına gelmez. Bu ayrım yazının geri kalanında belirleyici olacak.
llms.txt nasıl hazırlanır, hangi bölümler zorunlu?
Zorunlu olan tek öğe, dosyanın başındaki H1 başlıktır. Ardından alıntı bloğunda kısa bir özet, başlıksız açıklama paragrafları ve H2 başlıklı bağlantı listeleri gelir. Sıra öneride sabittir.
- H1 başlık: site ya da projenin adı. Önerideki tek zorunlu bölüm budur.
- Alıntı bloğu: sitenin ne yaptığını anlatan bir iki cümlelik özet.
- Açıklama: başlık içermeyen serbest paragraflar, örneğin iletişim ya da kullanım notu.
- H2 bölümleri: her satırda bir Markdown bağlantısı, isteğe bağlı olarak iki nokta ve kısa not.
- Optional bölümü: kısa bağlam gerektiğinde ajanın atlayabileceği ikincil bağlantılar.
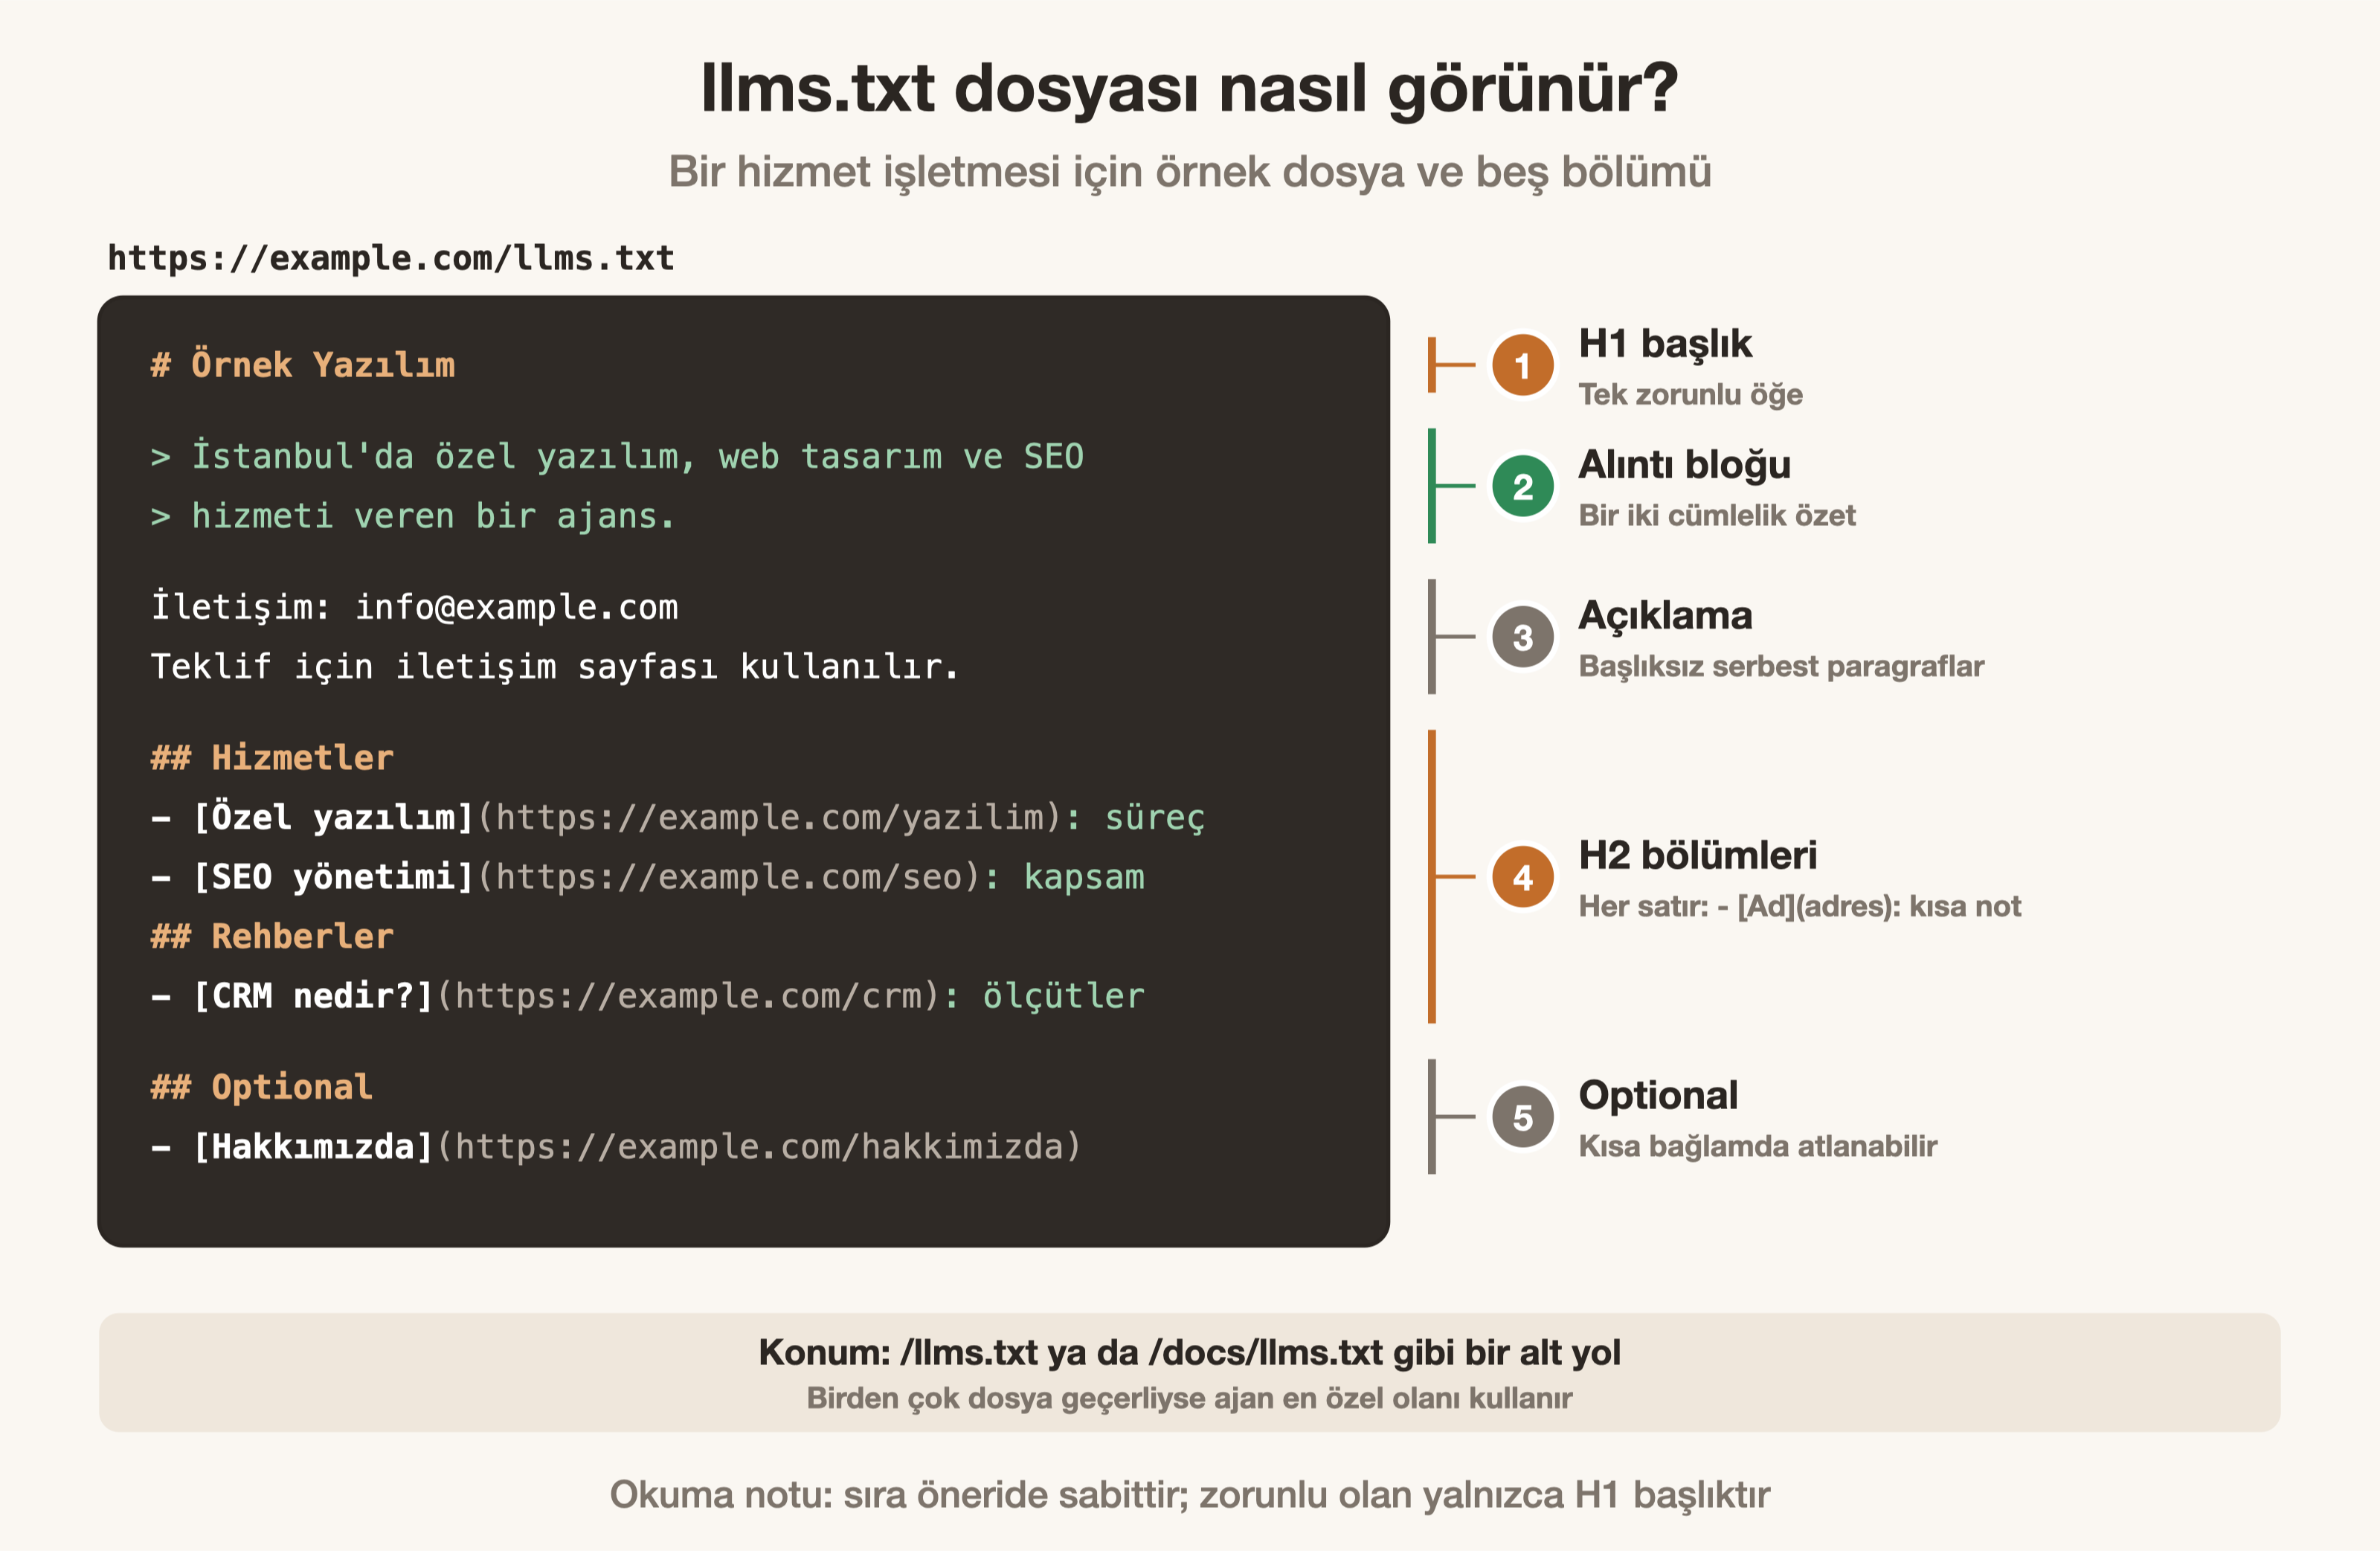
Dosya genelde kök dizinde, /llms.txt adresinde durur. İkinci sürüm alt yolları da kabul ediyor; /docs/llms.txt gibi bir dosya yalnızca kendi yolunun altını kapsar. Birden çok dosya geçerliyse ajan en özel olanı kullanmalıdır.
Öneri, sayfaların Markdown sürümlerinin de sunulmasını istiyor. Bunun için sayfa adresine .md eklenir ya da uzantı .md ile değiştirilir. Hizmet işletmesi için bu adım şart değildir (bizim sitemizde de yok). Asıl iş, dosyadaki bağlantı listesini doğru ve güncel tutmaktır.
robots.txt ve site haritasından farkı ne?
robots.txt erişim kuralı koyar, site haritası dizine girebilecek bütün sayfaları listeler. llms.txt ise seçilmiş bir özet sunar. Biri ötekinin yerini tutmaz; üçü aynı kökte yan yana durabilir.
| Konu | robots.txt | sitemap.xml | llms.txt |
|---|---|---|---|
| Görevi | Hangi yolun taranabileceğini söyler | Dizine girecek sayfaları bildirir | Sitenin özetini ve önemli bağlantılarını verir |
| Biçim | Düz metin yönergeler | XML | Markdown |
| Kapsam | Kurallar, sayfa listesi yok | Bütün dizinlenebilir sayfalar | Seçilmiş sayfalar, dış bağlantılar da olabilir |
| Durumu | 2022'den beri IETF standardı (RFC 9309) | Arama motorlarının desteklediği protokol | Öneri, standart değil |
| Kim okur? | Kurala uyan tarayıcılar | Arama motorları | Belirsiz; aşağıda ölçtük |
RFC 9309 bir ayrıntıyı açıkça yazar: robots.txt kuralları erişim yetkisi değildir. llms.txt ise hiçbir kural koymaz. Bir yapay zekâ botunu durdurmak istiyorsanız yol yine robots.txt'dir. Bot adlarını ve görevlerini GEO ve yapay zekâ aramalarında görünme yazımızda tablo hâlinde verdik.
llms-full.txt neyi değiştirir?
llms-full.txt, sitedeki sayfaların tam metnini tek bir Markdown dosyasında toplayan kardeş dosyadır. Önerinin metninde geçmez. Belge barındırma platformlarının yaygınlaştırdığı bir alışkanlıktır.
Boyut farkı büyüktür. Ekim başında bizim llms.txt dosyamız 44 bağlantı ve yaklaşık 13 KB tutuyordu. Aynı sayfaların tam metnini taşıyan llms-full.txt ise yaklaşık 850 KB idi. Bu boyutta bir dosya çoğu modelin bağlamına tek seferde sığmaz.
Büyük yapay zekâ şirketleri llms.txt'yi destekliyor mu?
Dosyayı tarayıcısıyla okuduğunu resmi olarak açıklayan büyük bir yapay zekâ şirketi yok. Google ise kullanmadığını belgelerine yazdı. OpenAI ve Anthropic'in tarayıcı belgeleri robots.txt'den söz eder, llms.txt'den değil.
Google'ın tutumu en net olanı. 15 Haziran 2026'da üretken yapay zekâ özellikleri rehberine bir not eklendi. Nota göre Arama'da görünmek için yeni makine okunur dosya, yapay zekâ metin dosyası ya da Markdown gerekmez. Google Arama bunları kullanmaz. Başka sistemler için dosya tutmak serbesttir; görünürlüğe ne zarar ne fayda sağlar.
Notun öncesinde de işaretler vardı. Google'dan John Mueller, Nisan 2025'te Reddit'te dosyayı keywords meta etiketine benzetti. Gerekçesi, dosyanın site sahibinin kendi beyanı olmasıydı. 17 Haziran 2025'te Bluesky'da da hiçbir yapay zekâ sisteminin llms.txt kullanmadığını yazdı.
Kafa karıştıran bir gelişme Chrome tarafında oldu. Lighthouse, 2026'da "agentic browsing" denetimlerine bir llms.txt kontrolü ekledi. Chrome belgesi dosyayı yeni ortaya çıkan bir alışkanlık olarak tanımlıyor. Dosya yoksa denetim "uygulanamaz" sayılıyor; yalnızca sunucu hatasında uyarı çıkıyor. Lighthouse sonucu bir arama sıralaması sinyali değildir.
OpenAI tarafında belge, botların robots.txt'ye uyduğunu ve IP listelerini anlatıyor. Anthropic de benzer şekilde robots.txt'yi ve bir IP listesini gösteriyor. İkisinin de kendi belge sitesinde llms.txt var. Tarayıcılarının başka sitelerde bu dosyayı aradığına dair bir ifade ise yok.
Dosyayı okuyan botlar sunucu günlüğünden nasıl ölçülür?
Nginx erişim günlüğünde /llms.txt isteklerini süzüp kullanıcı aracısına göre saymak yeterlidir. Ardından şüpheli bot adları resmi IP listeleriyle doğrulanır. İş beş adımda ve birkaç komutla biter.
- Günlük dosyalarını bulun; Ubuntu'da Nginx varsayılan olarak /var/log/nginx altına yazar.
- Döndürülmüş .gz dosyaları dahil hepsini zcat -f ile okuyun.
- GET /llms.txt satırlarını seçip kullanıcı aracısı alanını ayırın ve sayın.
- Aynı sayımı robots.txt için de yapın; karşılaştırma ölçeği verir.
- Bot adlarının geldiği IP adreslerini şirketlerin yayımladığı listelerle karşılaştırın.
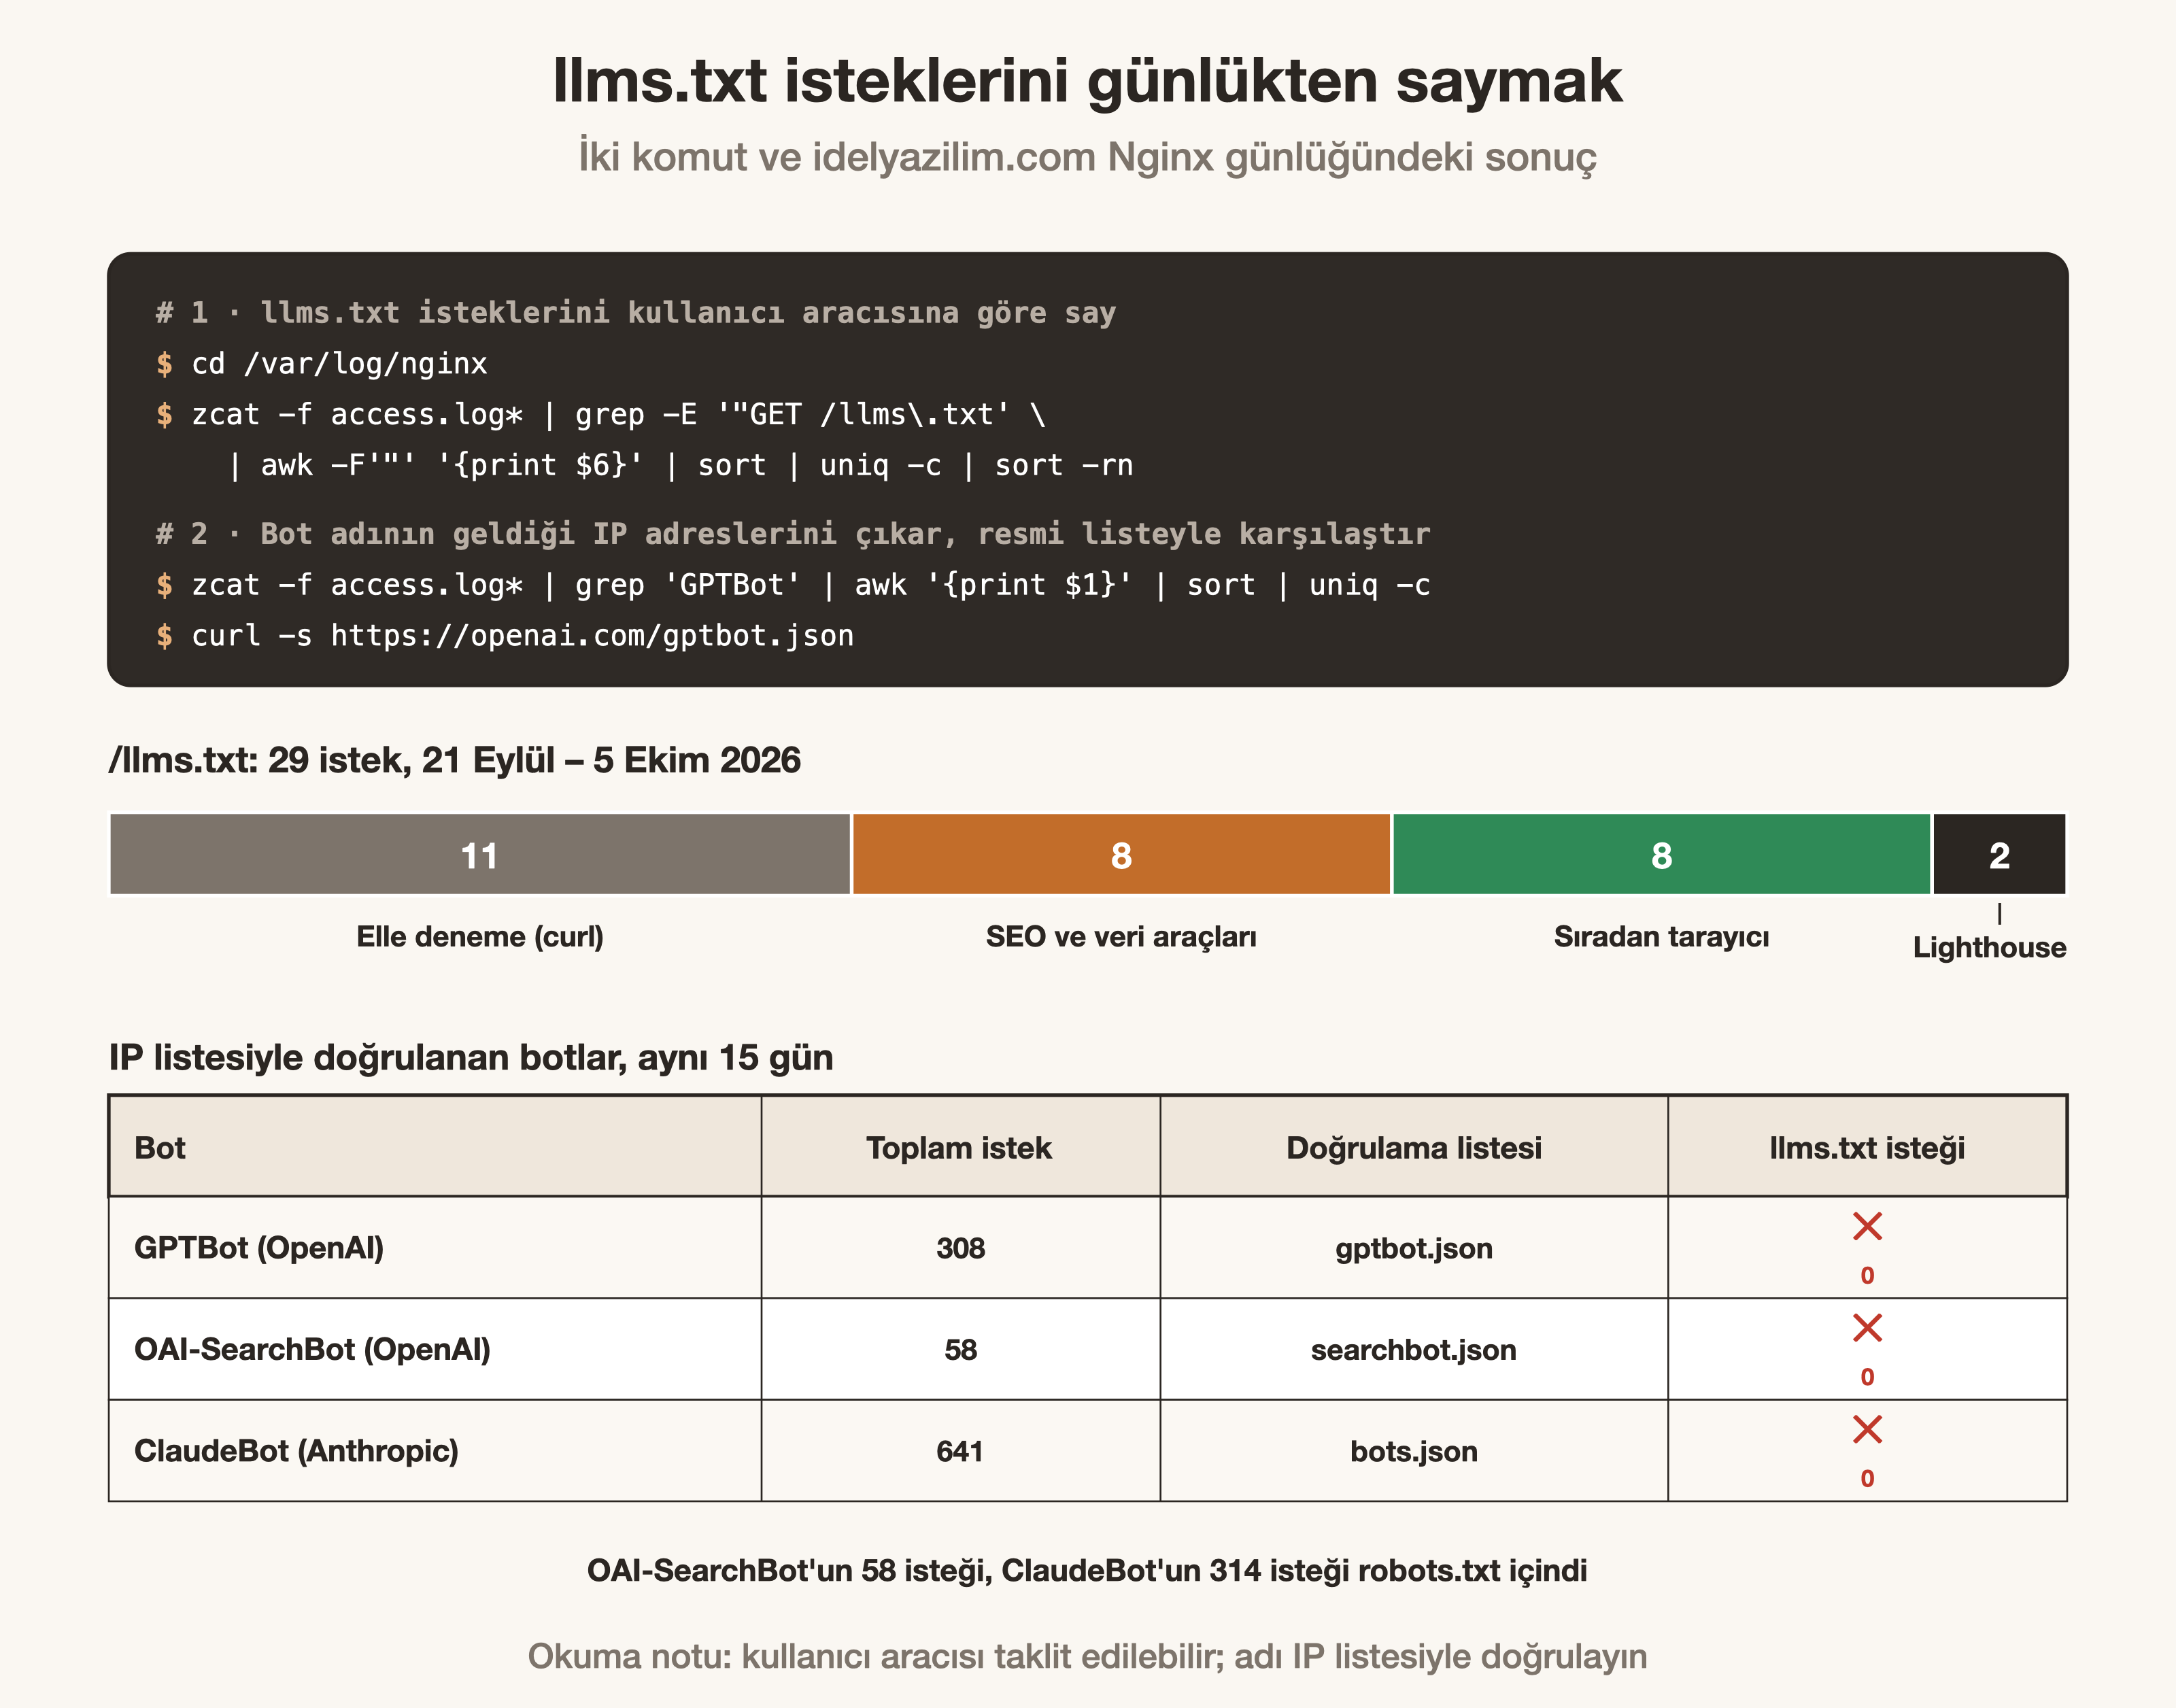
Son adım atlanmamalı, çünkü kullanıcı aracısı serbestçe yazılabilir. OpenAI GPTBot ve OAI-SearchBot için ayrı IP listeleri yayımlıyor. Anthropic de kendi botları için bir liste sunuyor. Listede olmayan bir adres, adı ne olursa olsun o şirketin botu sayılmaz.
Sitenin önünde Cloudflare gibi bir katman varsa iki şey kontrol edilir. Birincisi gerçek ziyaretçi IP'sinin günlüğe yazılmasıdır. İkincisi dosyanın önbellekten sunulup sunulmadığıdır; önbellekten giden istek sunucu günlüğüne düşmez. Bizde Cloudflare bu dosyayı önbelleğe almıyor, her istek günlüğe yazılıyor.
Kendi sitemizde 15 günde ne gördük?
21 Eylül ile 5 Ekim 2026 arasında /llms.txt adresine 29 istek geldi. Bilinen yapay zekâ tarayıcılarının hiçbiri bu istekler arasında yoktu. Aynı botlar sitenin geri kalanını düzenli taradı.
29 isteğin 11'i komut satırından yaptığımız elle denemelerdi. 8'i SEO ve veri tarama araçlarının botlarından geldi. 2'si Lighthouse ölçümüydü, 8'i ise sıradan tarayıcı kimliği taşıyordu. llms-full.txt'ye gelen 3 isteğin hepsi bizimdi.
Aynı dönemde OpenAI'ın listesinden doğruladığımız GPTBot 308 istek yaptı. OAI-SearchBot robots.txt dosyasını 58 kez okudu. Anthropic'in listesinden doğrulanan ClaudeBot 641 istek yaptı; bunların 314'ü robots.txt içindi. Üçünün llms.txt isteği sıfırdı.
Doğrulamanın neden şart olduğunu da gördük. Günlükte "Google-Extended" adını taşıyan 494 istek vardı. Oysa Google-Extended bir tarayıcı değil, yalnızca robots.txt'te kullanılan bir izin işaretidir. Bu istekler WordPress ve yönetim yollarını yoklayan bir tarayıcıdan geliyordu.
Sınırı da söylemek gerekir. Tek bir site ve 15 günlük bir pencere var. Bir ajan kullanıcı isteğiyle gelirse sıradan tarayıcı kimliği taşıyabilir; o 8 isteği bu yüzden ayıramıyoruz. Yine de büyük tarayıcıların dosyayı aramadığı açık.
Aynı sayımı kendi sitenizde birkaç dakikada yapabilirsiniz. Sonuç bizimkinden farklı çıkarsa, hangi botun ve hangi IP'nin istediğine bakmak yeterli bir başlangıçtır.
Next.js sitede llms.txt nasıl otomatik üretilir?
app klasöründe llms.txt adlı bir klasör ve içinde route.ts dosyası açılır. Bu dosyadaki GET işleyicisi sayfa listesini alıp Markdown metni döndürür. Böylece llms.txt hiçbir zaman elle güncellenmez.
Next.js'te bu yapının adı Route Handler'dır ve sayfa dışı yanıtlar için kullanılır. Next.js 15'ten beri GET işleyicileri varsayılan olarak her istekte çalışır. Dosyayı önbelleğe almak için revalidate ayarı verilir. Bizim sitemiz Next.js, PHP ve MySQL ile kendi geliştirdiğimiz bir yapı; llms.txt de bu yolla üretiliyor.
- Sayfa listesi site haritasıyla aynı kaynaktan gelir; taslak, silinmiş ve dizine kapalı kayıt zaten yoktur.
- İlk satıra kurum adı H1 olarak, altına alıntı bloğuyla kısa tanım yazılır.
- Kategoriler ve sayfalar iki ayrı H2 bölümünde listelenir.
- Her açıklama tek satıra indirilir ve 160 karakterde kesilir.
- Dosyanın sonuna site haritasının bağlantısı eklenir.
- Yanıt text/plain ve UTF-8 olarak gider, önbellek süresi 3600 saniyedir.
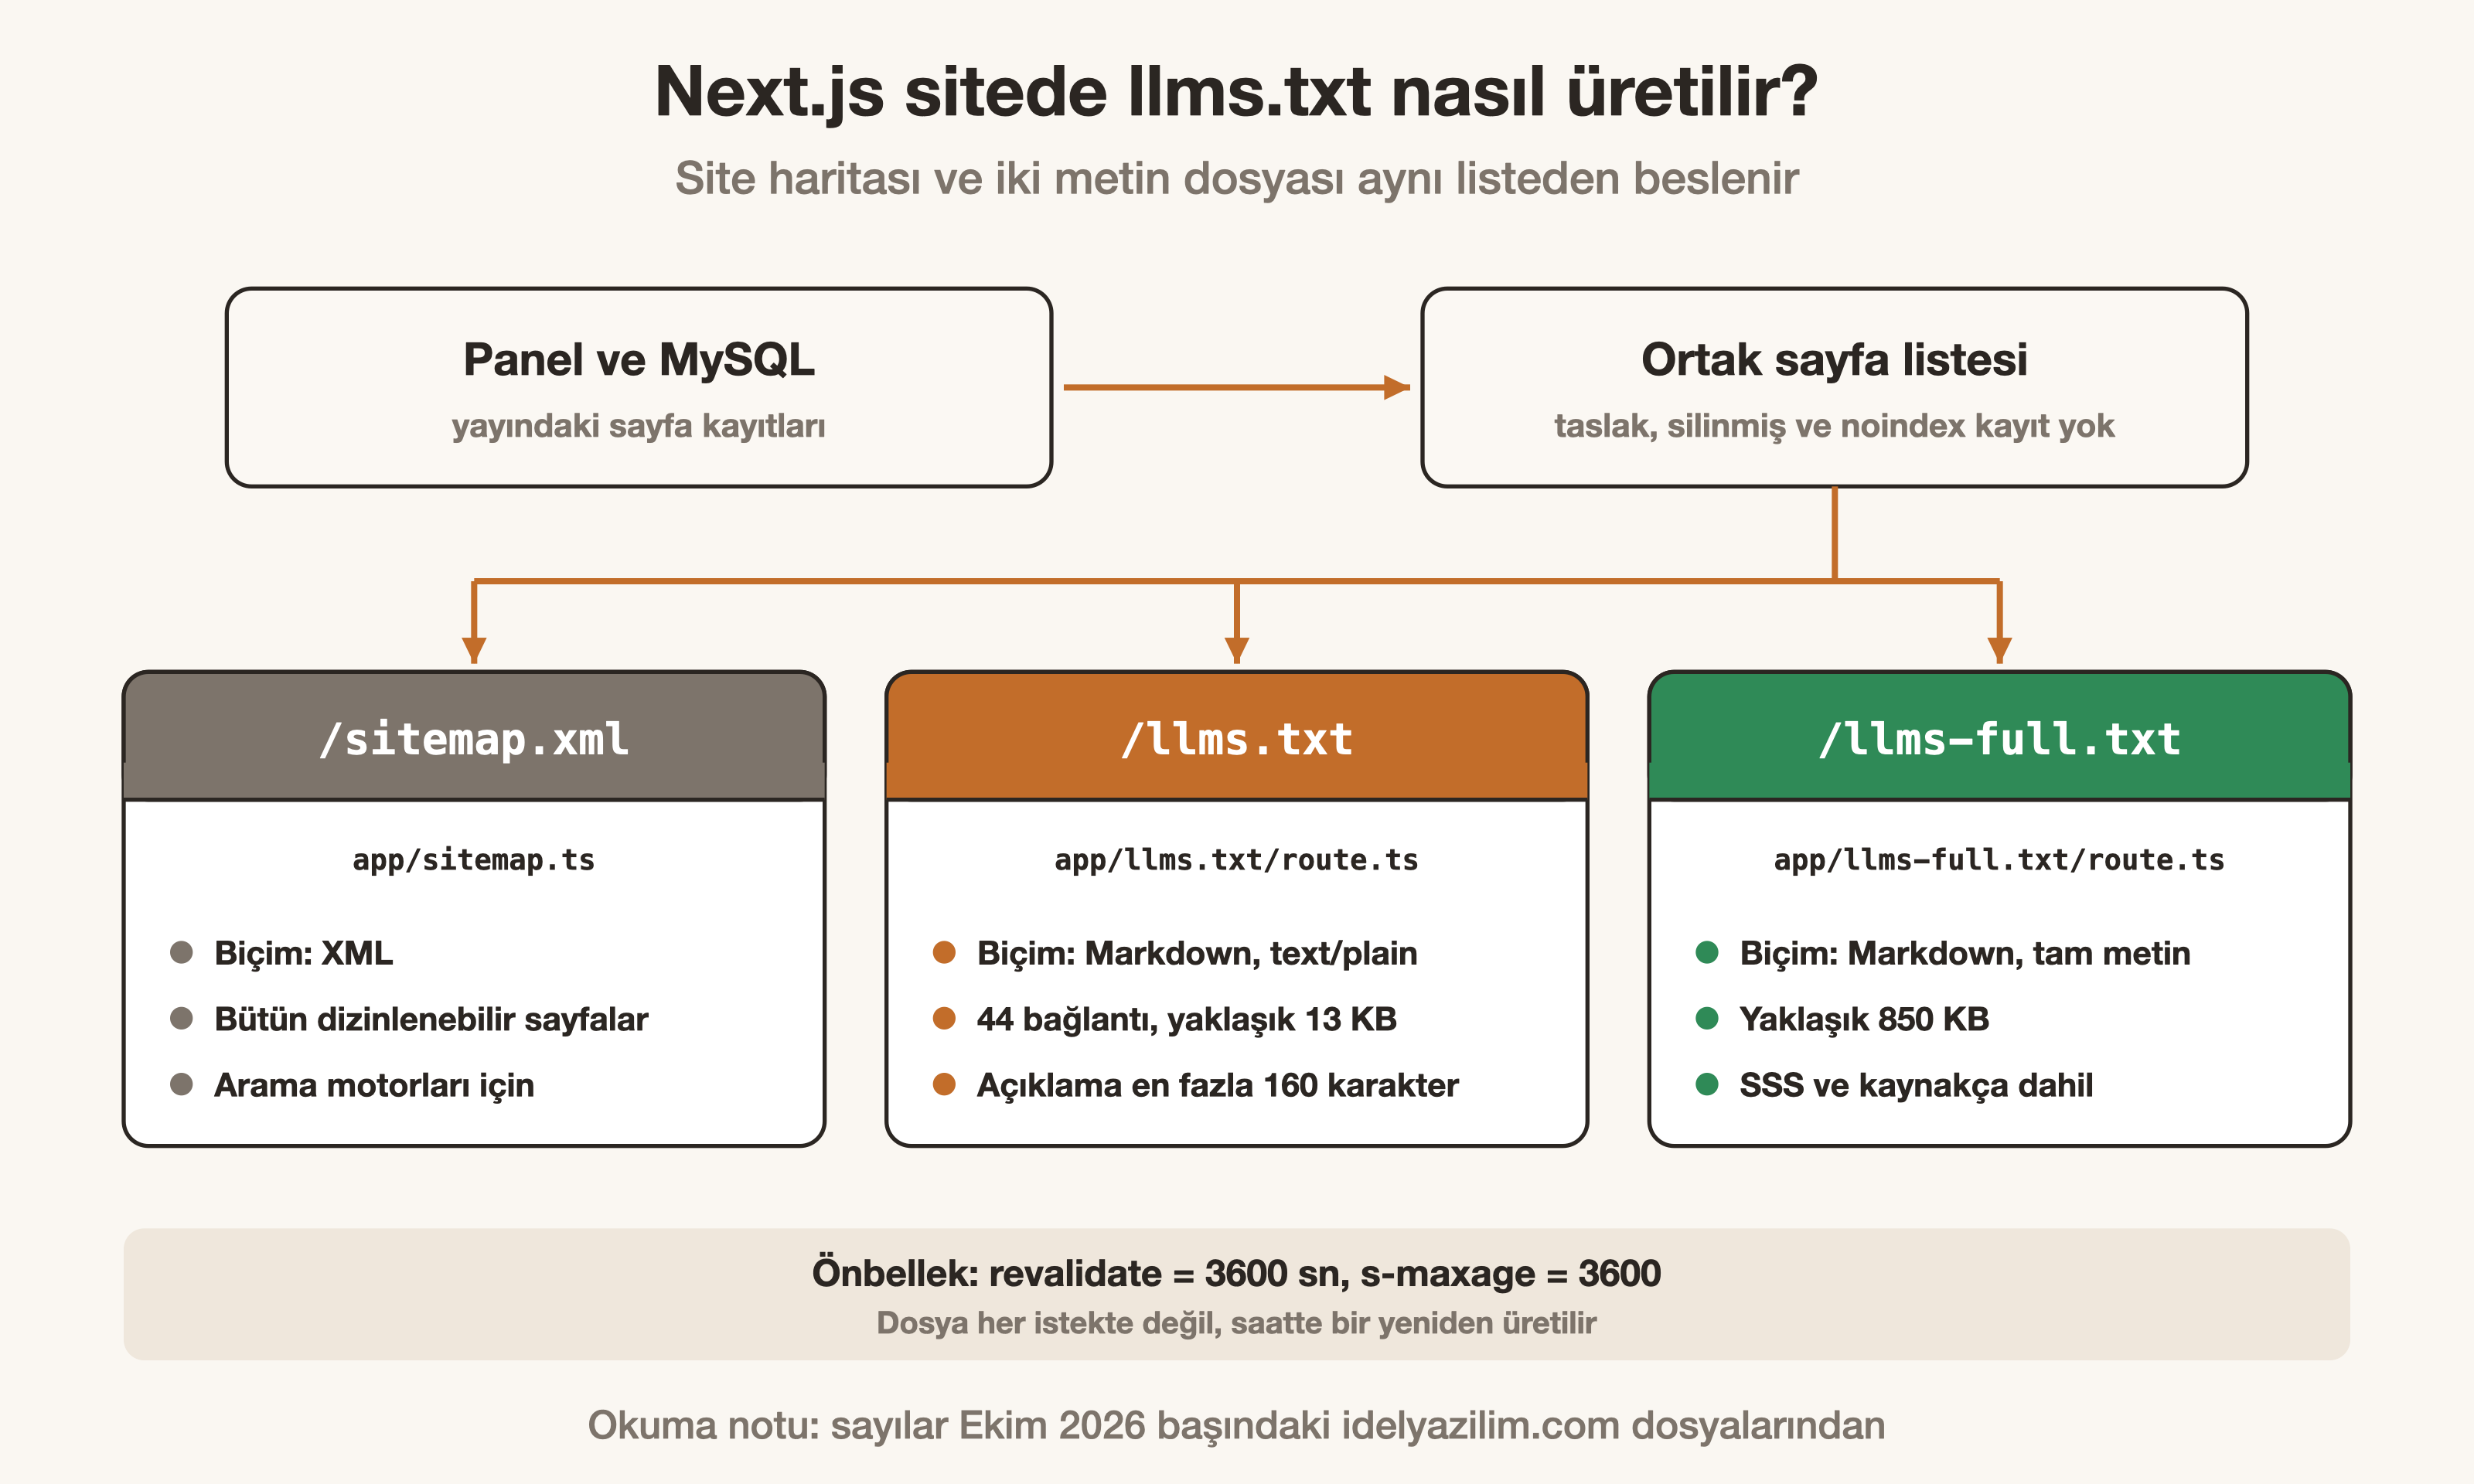
160 karakter Google ya da önerinin koyduğu bir sınır değildir; bizim kullandığımız eşiktir. Amaç, her satırın tek bakışta okunması. 3600 saniyelik önbellek de bizim tercihimiz. Yeni bir yazı listeye kabaca bir saat içinde giriyor. Dosya her istekte veritabanını yormuyor, saatte bir yeniden üretiliyor.
WordPress'te bu iş çoğu zaman bir eklentiyle yapılır. Next.js'te ise eklenti yerine birkaç düzine satırlık bir işleyici yeter. İki yapının genel farkını Next.js ile WordPress karşılaştırması sayfamızda anlattık.
llms.txt işe yarıyor mu, beklenti ile gerçek ne?
Google Arama ve AI Overviews gibi yapay zekâ cevapları için işe yaramadığı resmi olarak belli. Diğer sistemler için kanıt zayıf; büyük tarayıcılar dosyayı istemiyor. Ajanların kullanıcı isteğiyle okuması mümkün, ama bunu dışarıdan ölçmek zor.
| Beklenti | Bugünkü durum |
|---|---|
| Google sıralaması artar | Google'a göre ne yardım eder ne zarar verir |
| AI Overviews ve AI Mode'da daha çok görünürüm | Google Arama bu dosyaları kullanmıyor |
| ChatGPT dosyayı okuyup beni önerir | OpenAI'ın belgesinde böyle bir ifade yok; günlüğümüzde de görmedik |
| Botları yönlendirir ya da engeller | Hayır, erişim kuralları robots.txt ile konur |
| Kodlama ajanları belgeyi daha kolay okur | Önerinin asıl hedefi bu; belge siteleri için mantıklı |
Ölçülebilir yapay zekâ görünürlüğü başka yerden gelir. Sayfanın dizinde olması, botlara izin verilmesi ve içeriğin net yazılması bunların başında. Google tarafındaki tıklama ve gösterim verisini Search Console'da üretken yapay zekâ performansı yazımızda ele aldık.
Hangi site için yapmaya değer?
Dosya otomatik üretilebiliyorsa ve içerik belge ya da başvuru niteliğindeyse yapmaya değer. Elle tutulacak ve eskiyecek bir dosyaysa acele etmeye gerek yok. Aşağıdaki tablo bizim önerimizdir, bir şirketin kuralı değil.
| Durum | Önerimiz | Neden |
|---|---|---|
| Geliştirici belgesi, API ya da yazılım ürünü | Yapın | Kodlama ajanları önerinin asıl kullanıcısı |
| Sayfa listesi veritabanından gelen site | Yapın, otomatik üretin | Maliyeti bir kez yazılan işleyiciden ibaret |
| Elle güncellenen küçük kurumsal site | Acele etmeyin | Eskiyen dosya yanlış bilgi taşır |
| Tek hedef Google sıralaması | Gerekmez | Google Arama dosyayı kullanmıyor |
| Yüzlerce uzun sayfa | Yalnızca llms.txt | llms-full.txt bağlama sığmayacak kadar büyür |
Biz dosyayı tutuyoruz, çünkü üretimi otomatik ve maliyeti yok denecek kadar az. Beklentimizi ise günlüğe göre ayarlıyoruz. Önerimiz, sayımı üç ayda bir tekrarlamak ve sonucu robots.txt istekleriyle yan yana koymaktır.
Sırayı ters kurmamak gerekir. Taranamayan, yavaş ya da dizine girmeyen bir site llms.txt ile kurtulmaz. Önce SEO teknik kontrol listesi tamamlanmalı. Teknik denetimi, bot izinlerini ve günlük ölçümünü SEO yönetimi hizmetimiz içinde birlikte yürütüyoruz.
Sıkça sorulan sorular
- Llms.txt nedir?
- Llms.txt, sitenin ne anlattığını ve önemli bağlantılarını dil modellerine Markdown ile tanıtan bir dosyadır. Jeremy Howard 2024'te önerdi; resmi standart değildir.
- Llms.txt Google sıralamasını etkiler mi?
- Etkilemez. Google, Arama'nın bu dosyaları kullanmadığını ve görünürlüğe ne zarar ne fayda sağladığını belgelerine yazdı.
- ChatGPT ya da Claude llms.txt dosyasını okuyor mu?
- OpenAI ve Anthropic'in tarayıcı belgelerinde böyle bir ifade yok. Kendi günlüğümüzde 15 günde GPTBot, OAI-SearchBot ve ClaudeBot dosyayı hiç istemedi.
- Llms.txt ile robots.txt arasındaki fark nedir?
- Robots.txt hangi yolun taranabileceğini söyler. llms.txt ise kural koymaz, yalnızca sitenin özetini ve bağlantılarını verir.
- Llms-full.txt nedir?
- Sitedeki sayfaların tam metnini tek Markdown dosyasında toplayan kardeş dosyadır. Önerinin metninde geçmez ve büyük sitelerde çok hacimli olur.
- Llms.txt dosyasını hangi botun okuduğunu nasıl anlarım?
- Nginx erişim günlüğünde /llms.txt isteklerini süzüp kullanıcı aracısına göre sayın. Bot adlarını şirketlerin yayımladığı IP listeleriyle doğrulayın.
- Next.js sitede llms.txt nasıl üretilir?
- App/llms.txt/route.ts dosyasında bir GET işleyicisi yazılır. İşleyici sayfa listesini alıp Markdown metni döndürür, revalidate ile önbelleğe alınır.
- Llms.txt yapmaya değer mi?
- Belge sitelerinde ve otomatik üretilebiliyorsa değer. Tek hedef Google sıralamasıysa gerekmez.
Kaynakça
- The /llms.txt file (llmstxt.org) — Önerinin yazarını, 2024 yayın ve 2026 güncelleme tarihini, dosya biçimini, alt yol kuralını ve robots.txt ile site haritası farkını destekler.
- Optimizing your website for generative AI features on Google Search (Google Search Central) — Google Arama'nın llms.txt ve benzeri dosyaları kullanmadığını, görünürlüğe ne zarar ne fayda sağladığını destekler.
- llms.txt denetimi (Chrome for Developers, Lighthouse) — Lighthouse'un dosya yoksa denetimi uygulanamaz saydığını, yalnızca sunucu hatasında uyardığını destekler.
- Overview of OpenAI Crawlers — OpenAI botlarının robots.txt'ye uyduğunu ve doğrulama için IP listeleri yayımlandığını destekler.
- Does Anthropic crawl data from the web? (Claude Yardım Merkezi) — Anthropic botlarının robots.txt'ye uyduğunu ve IP listesiyle doğrulanabildiğini destekler.
- RFC 9309: Robots Exclusion Protocol (IETF) — robots.txt'nin 2022'de standart olduğunu ve kuralların erişim yetkisi sayılmadığını destekler.