Schema markup (yapısal veri), bir sayfanın neyi anlattığını arama motorlarına makine okunur biçimde bildiren koddur. Google bu kodu sayfayı anlamak ve bazı sonuçları zengin görünümle göstermek için kullanır. Aşağıda JSON-LD biçimini, düğümleri @graph ve @id ile bağlamayı anlatıyoruz. Hangi türün hâlâ zengin sonuç verdiğini ve SSS şemasına ne olduğunu da ele alıyoruz. Sonda iki test aracının farkı ve sık hatalar var.
Schema markup nedir, ne işe yarar?
Schema markup, sayfadaki bilgiyi schema.org sözlüğündeki türler ve özelliklerle etiketleyen koddur. Ziyaretçi bu kodu görmez; arama motoru okur. Doğru kurulduğunda sayfa yıldız, fiyat ya da kırıntı yolu gibi zengin sonuçlara aday olur.
Bir tarif sayfasını düşünün. Metinde pişirme süresi "20 dakika" diye geçer. Yapısal veri aynı bilgiyi "cookTime" adlı bir alana koyar. Arama motoru artık o sayının bir süre olduğunu tahmin etmek zorunda kalmaz.
Google, yapısal verinin zengin sonucu garanti etmediğini açıkça yazıyor. Kod kusursuz olsa bile Google düz metin sonucu daha uygun bulabilir. Kural ihlali varsa elle işlem de gelebilir. O durumda sayfa zengin sonuç hakkını kaybeder, sıralaması etkilenmez.
Neden JSON-LD biçimi öneriliyor?
JSON-LD, yapısal veriyi sayfa metninden ayrı bir script etiketinde tutan biçimdir. Google üç biçimi de kabul ediyor: JSON-LD, Microdata ve RDFa. Bakımı en kolay olduğu için JSON-LD'yi öneriyor.
Microdata ve RDFa, etiketleri görünen HTML'in içine serpiştirir. Tasarım değiştiğinde işaretleme de kolayca bozulur. JSON-LD ise tek bir blokta durur ve şablondan bağımsız üretilebilir. Google, JavaScript ile sonradan eklenen JSON-LD'yi de okuyabildiğini belirtiyor.
@graph ve @id ile düğümler nasıl bağlanır?
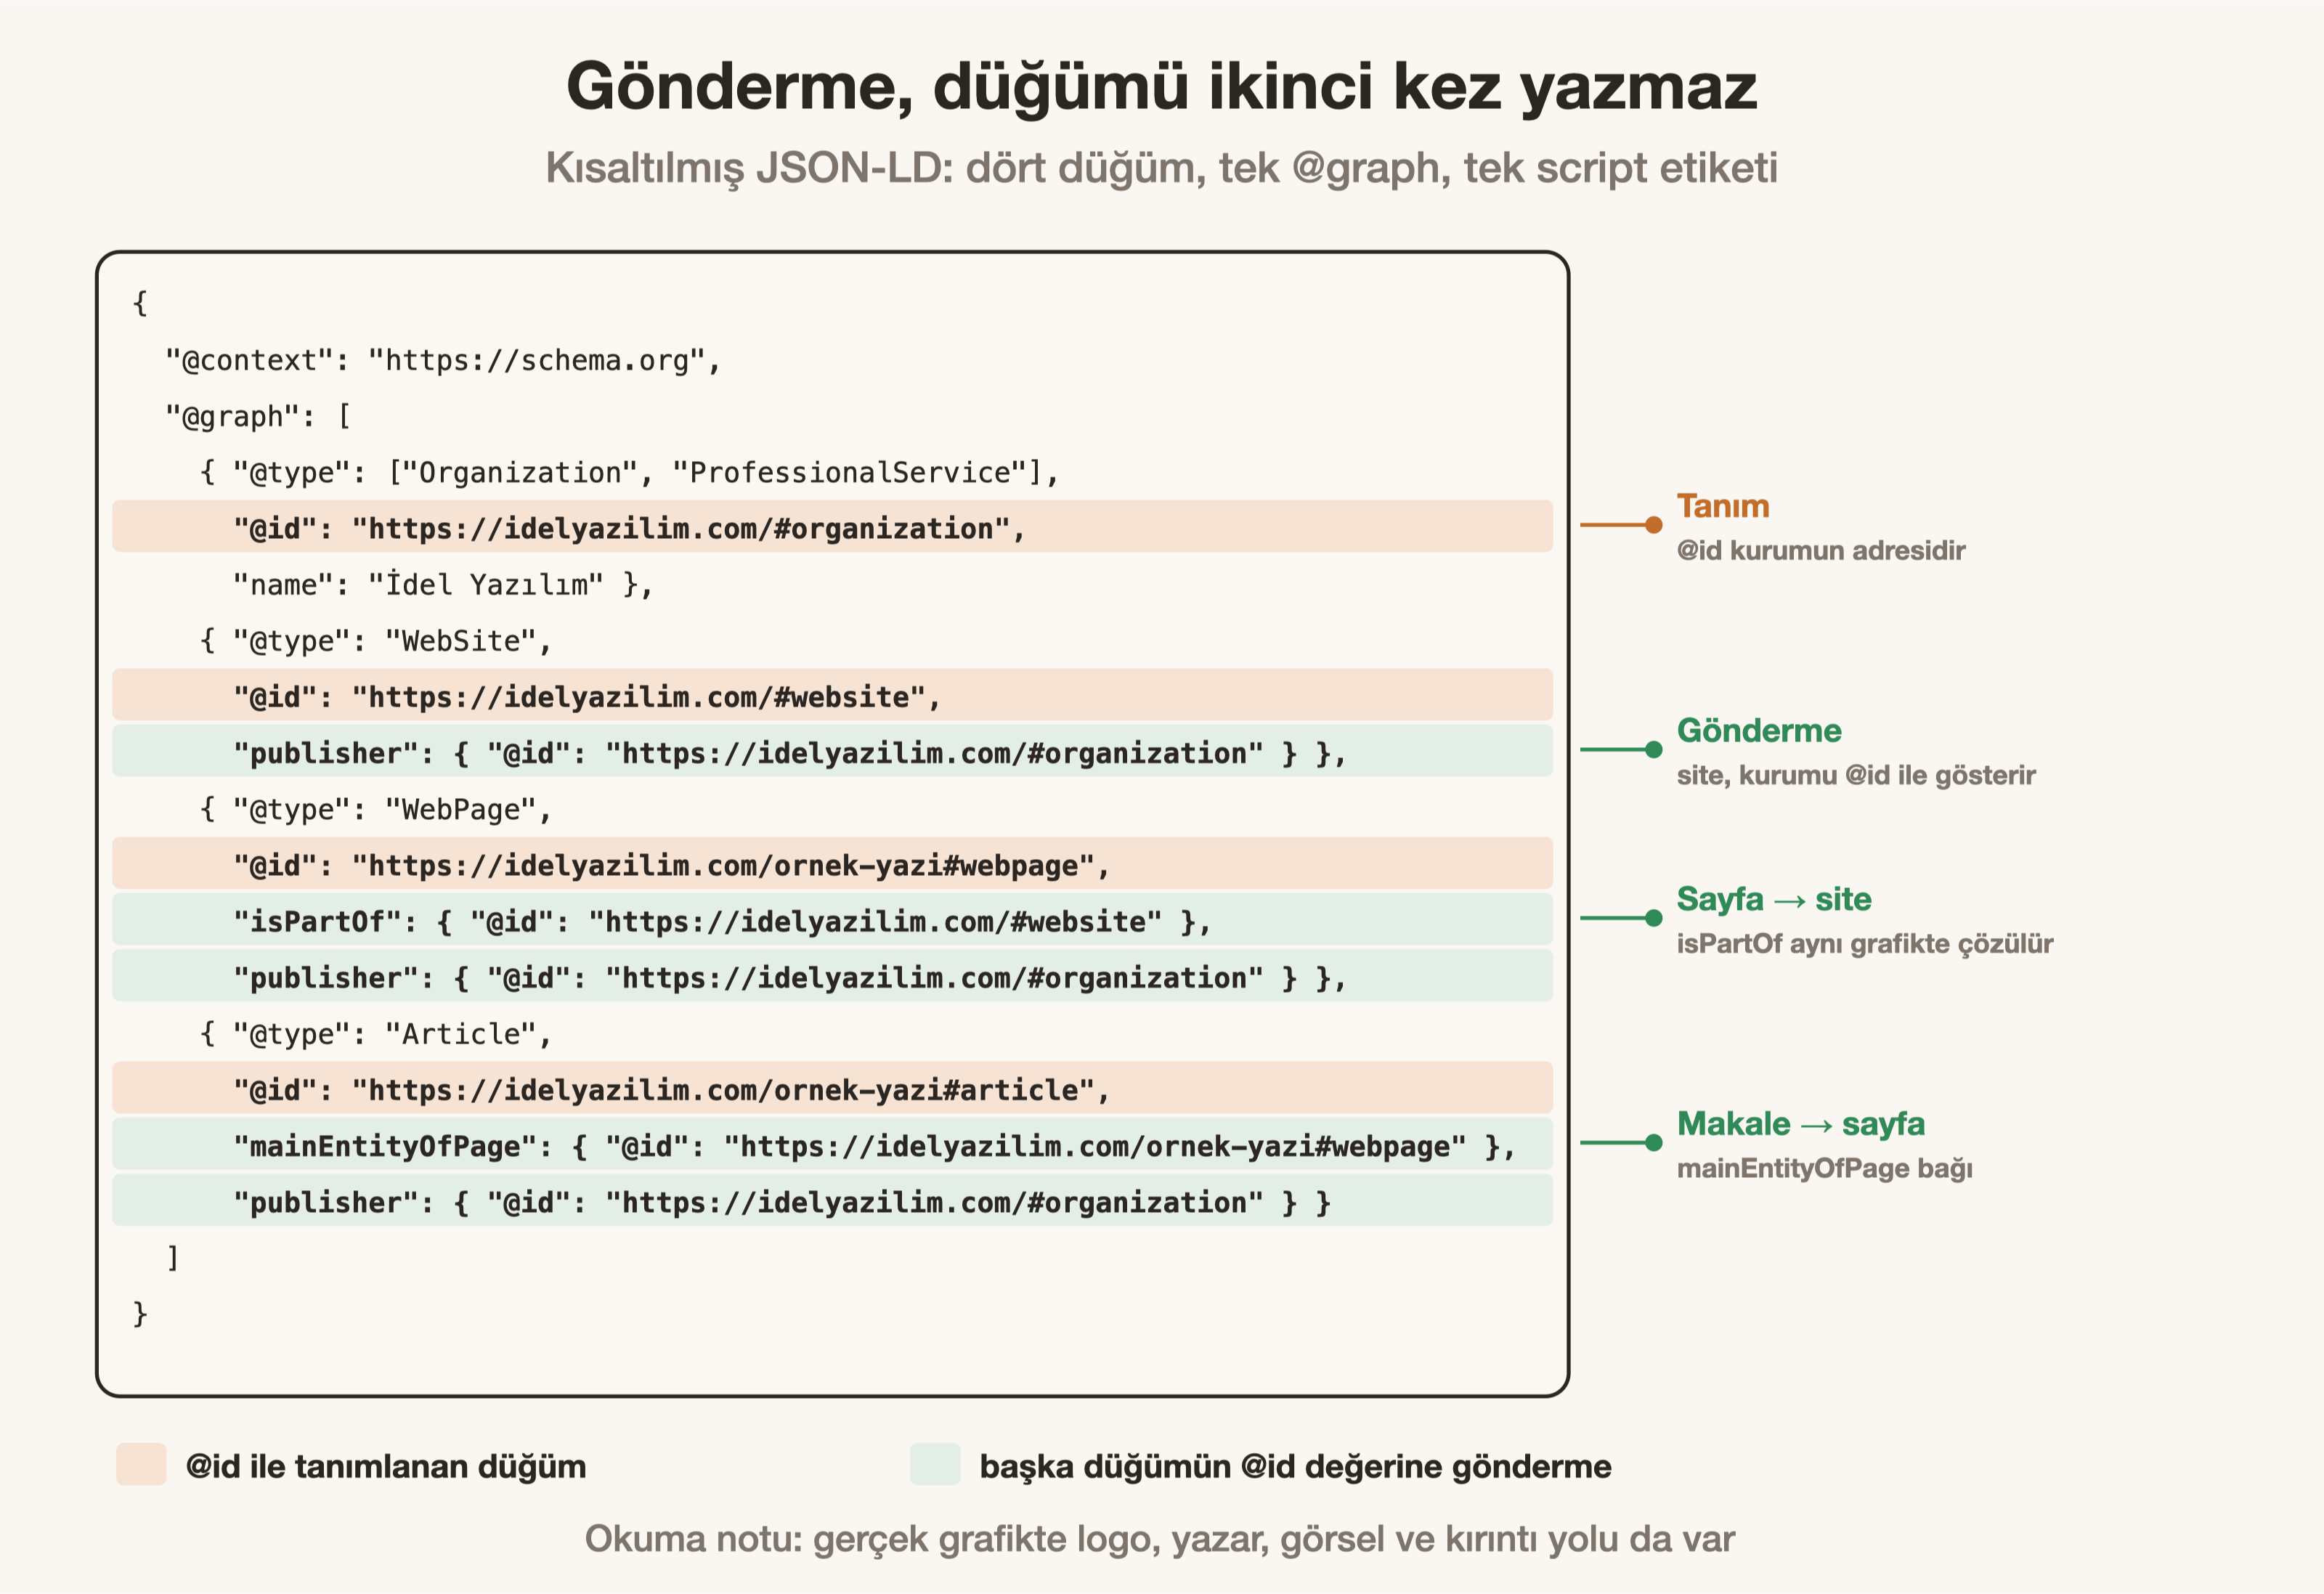
@graph, bir sayfadaki bütün yapısal veri düğümlerini tek listede toplayan alandır. @id ise her düğüme verilen benzersiz bir adrestir. Bir düğüm başka bir düğümü yeniden yazmaz; yalnızca onun @id değerini gösterir.
Düğüm, tek bir şeyi anlatan nesnedir: kurum, site, sayfa, makale, yazar ya da kırıntı yolu. Örneğin kurum düğümünün kimliği "https://idelyazilim.com/#organization" olabilir. Makale düğümü yayıncıyı yazarken bu kimliği verir. Böylece kurum bilgisi her sayfada bir kez yazılır ve her yerde aynı kalır.
Google'ın genel yönergesi de bunu öneriyor. Birlikte anlam taşıyan öğeler ayrı yazıldıysa, ikisinde de @id kullanılması isteniyor. Bağ kurulmazsa Google, örneğin videonun hangi tarife ait olduğunu bilemeyebilir.
Kendi sitemizde grafik nasıl kuruluyor?
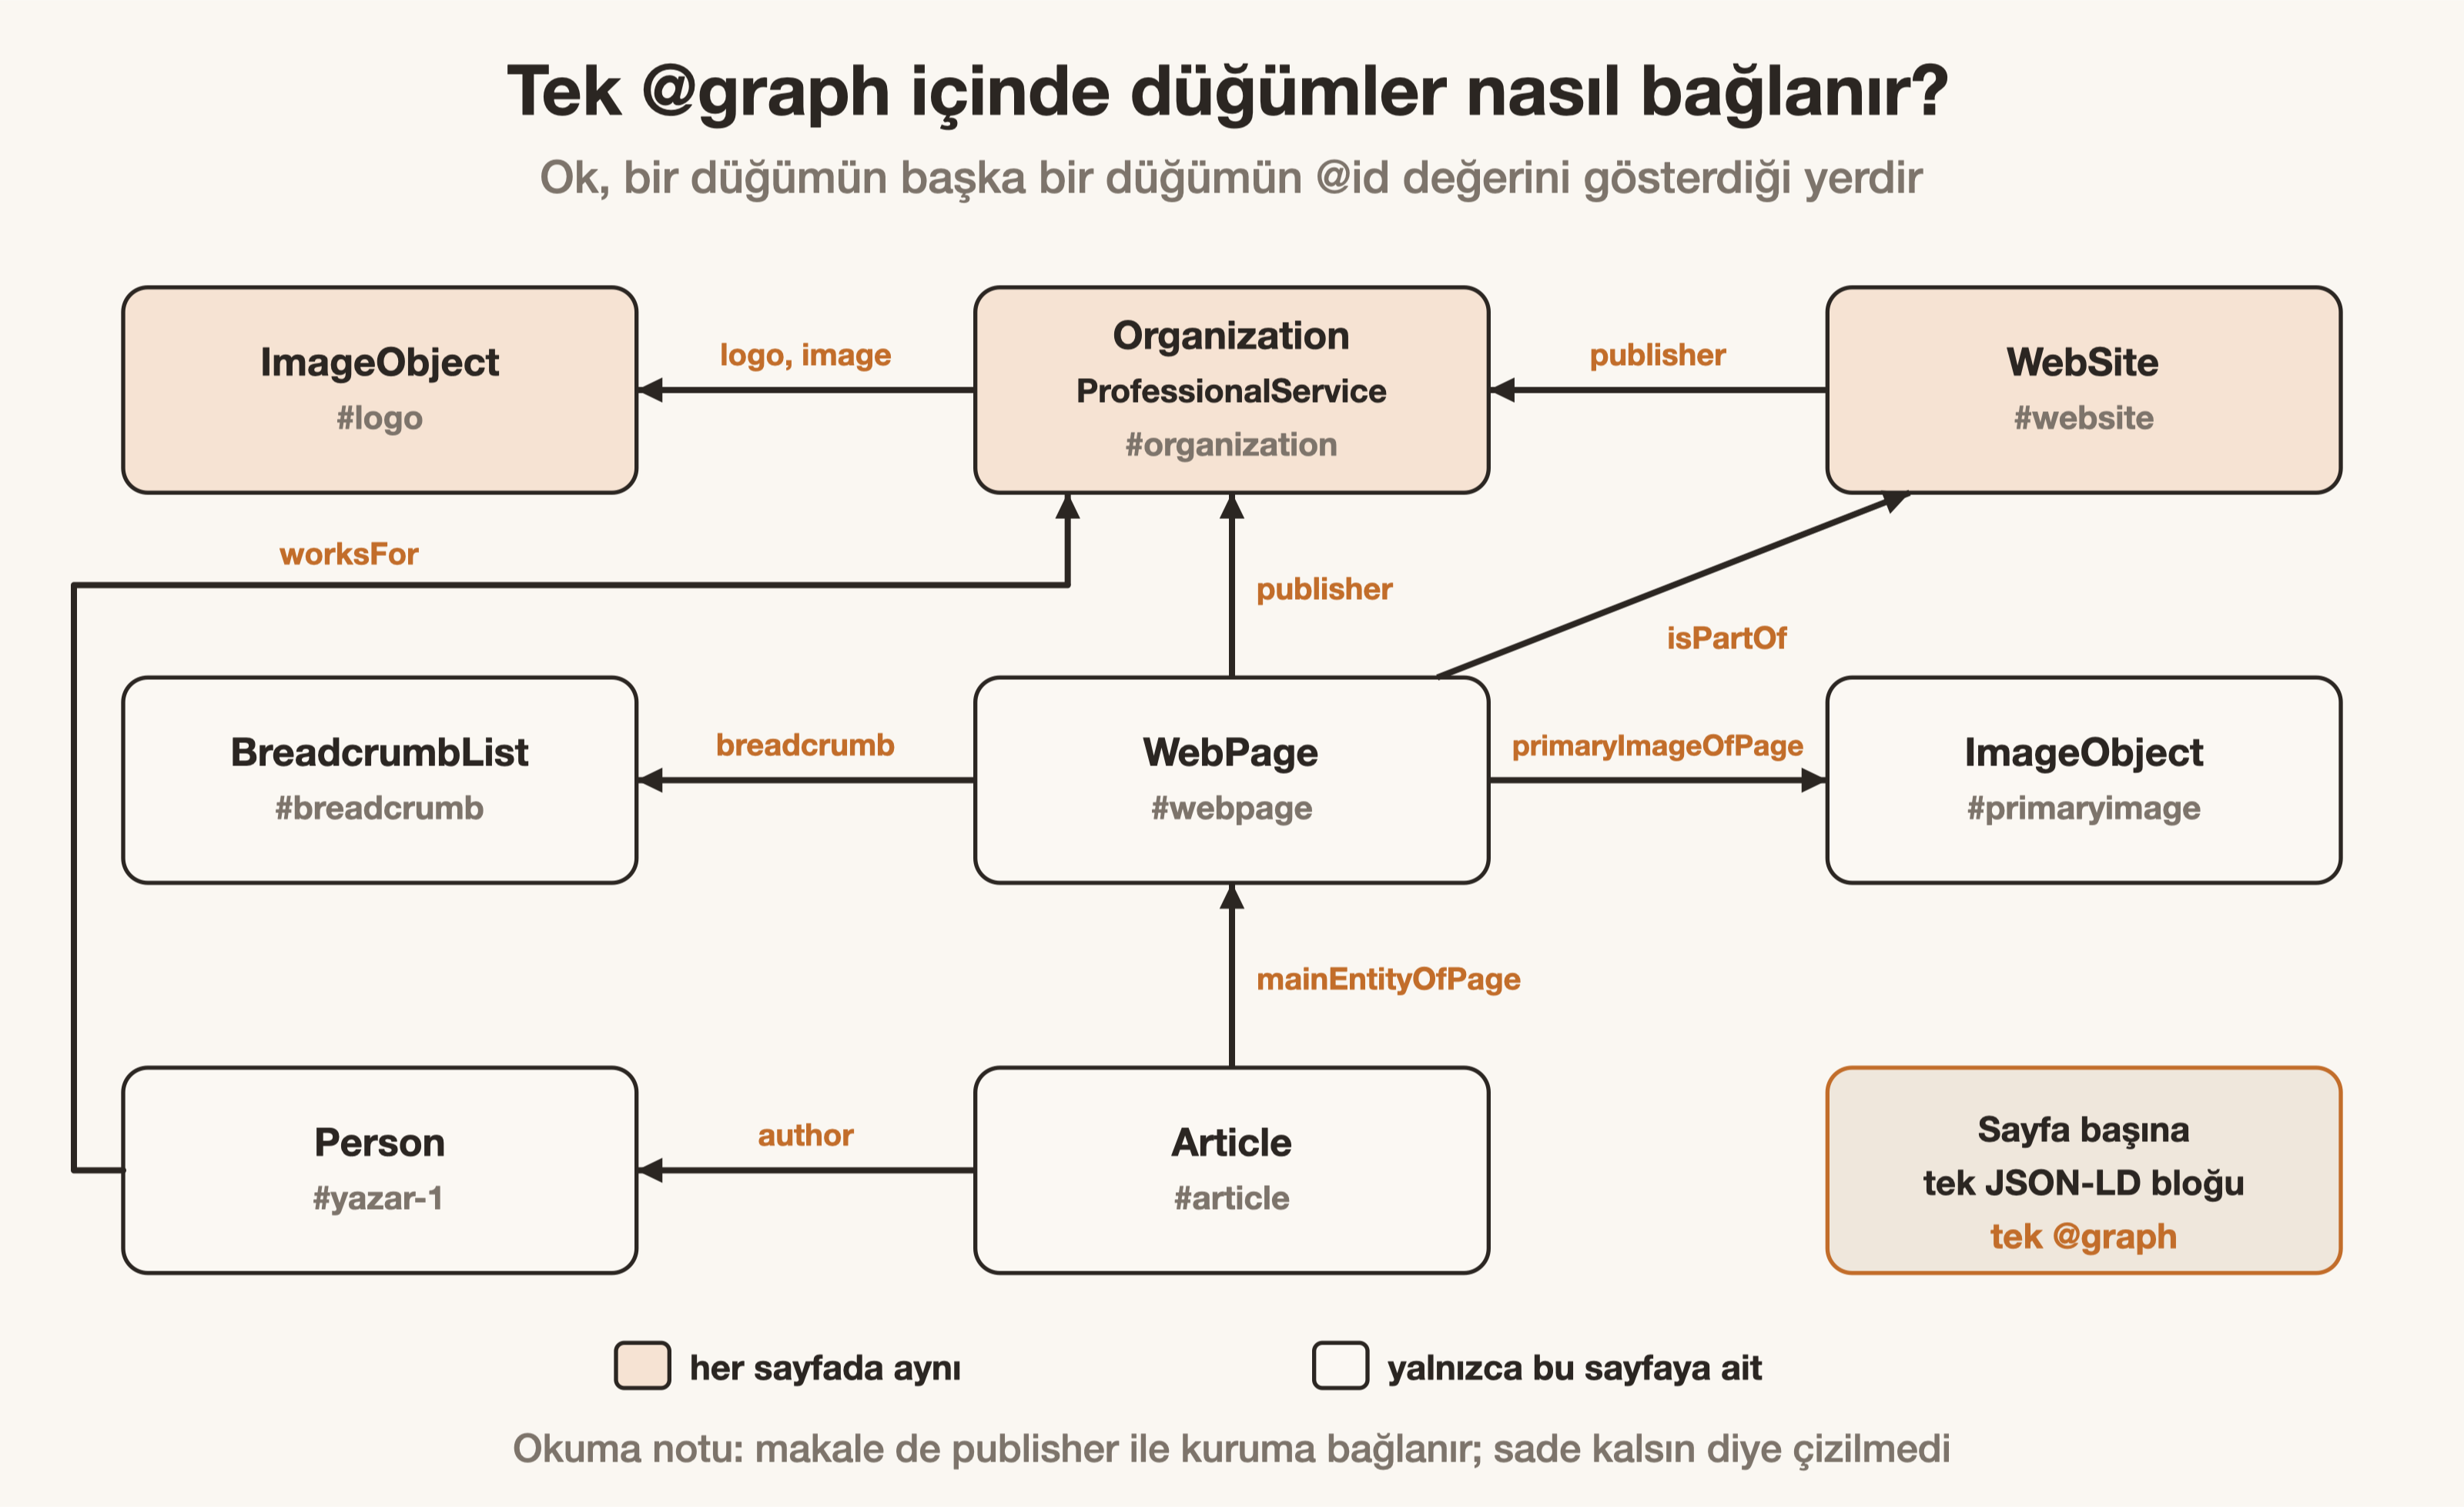
Her sayfamızda tek bir yapısal veri grafiği (@graph) kullanıyoruz. Sayfa başına tek bir JSON-LD bloğu basılıyor. Kurum, site ve sayfa düğümleri aynı listede duruyor.
Önceden kurum düğümleri ayrı bir blokta basılıyordu. Bağların çözülmesi o durumda arama motoruna kalıyordu. Şimdi listenin başına her sayfada logo, kurum ve site düğümleri ekleniyor. Ardından sayfaya özgü düğümler geliyor: görsel, yazar, kırıntı yolu, sayfa ve makale.
Kurum düğümümüz iki türü birlikte taşıyor: Organization ve ProfessionalService. Logo kendi düğümünde duruyor; kurum ona hem logo hem görsel olarak bağlanıyor. İç içe yazılsaydı aynı görsel iki kez tanımlanırdı. Görsel ölçüsü bilinmiyorsa genişlik ve yükseklik hiç yazılmıyor (tahmini ölçü yazmak yerine boş bırakmayı tercih ediyoruz).
Bir blog yazısının grafiğinde hangi düğümler var?
Bizim bir blog yazımızın grafiğinde çoğunlukla sekiz düğüm bulunuyor. Üçü her sayfada aynıdır: logo, kurum ve site. Kalan beşi o yazıya aittir.
- ImageObject (kapak görseli): sayfa ve makale ona bağlanır.
- Person: yazarın profil adresini taşır ve worksFor ile kuruma bağlanır.
- BreadcrumbList: Ana sayfa, kategori ve yazının kendisinden oluşan üç basamaklı yol.
- WebPage: isPartOf ile siteye, breadcrumb ile kırıntı yoluna bağlanır.
- Article: mainEntityOfPage ile sayfaya bağlanır; yazar ve yayıncı da burada yazılır.
Kimlikleri tek bir kurala göre veriyoruz. Site geneli düğümler kök adrese bir parça ekler: "/#organization", "/#website", "/#logo". Sayfa düğümleri ise sayfanın adresine eklenir: "#webpage", "#breadcrumb", "#article". Kurala bakan biri, bir kimliğin neyi gösterdiğini adından anlar.
Makale düğümünde birkaç alan daha var. Başlık en fazla 110 karakterle kesiliyor. Yazının kaynakçası citation alanına, kelime sayısı wordCount alanına yazılıyor. Kaynakça zaten sayfanın altında görünür durduğu için işaretlemesi de kurala uygun.
Hangi şema türü hangi zengin sonucu verir?
Her şema türünün Google'da bir karşılığı yoktur. Google, desteklediği türleri yapısal veri galerisinde listeliyor. WebSite ve WebPage gibi türler tek başına zengin sonuç açmaz, ama grafiğin iskeletini kurar.
| Tür | Google'daki karşılığı | Not |
|---|---|---|
| Article | Başlık ve küçük resimden büyük görsel | Haber ve blog yazıları için |
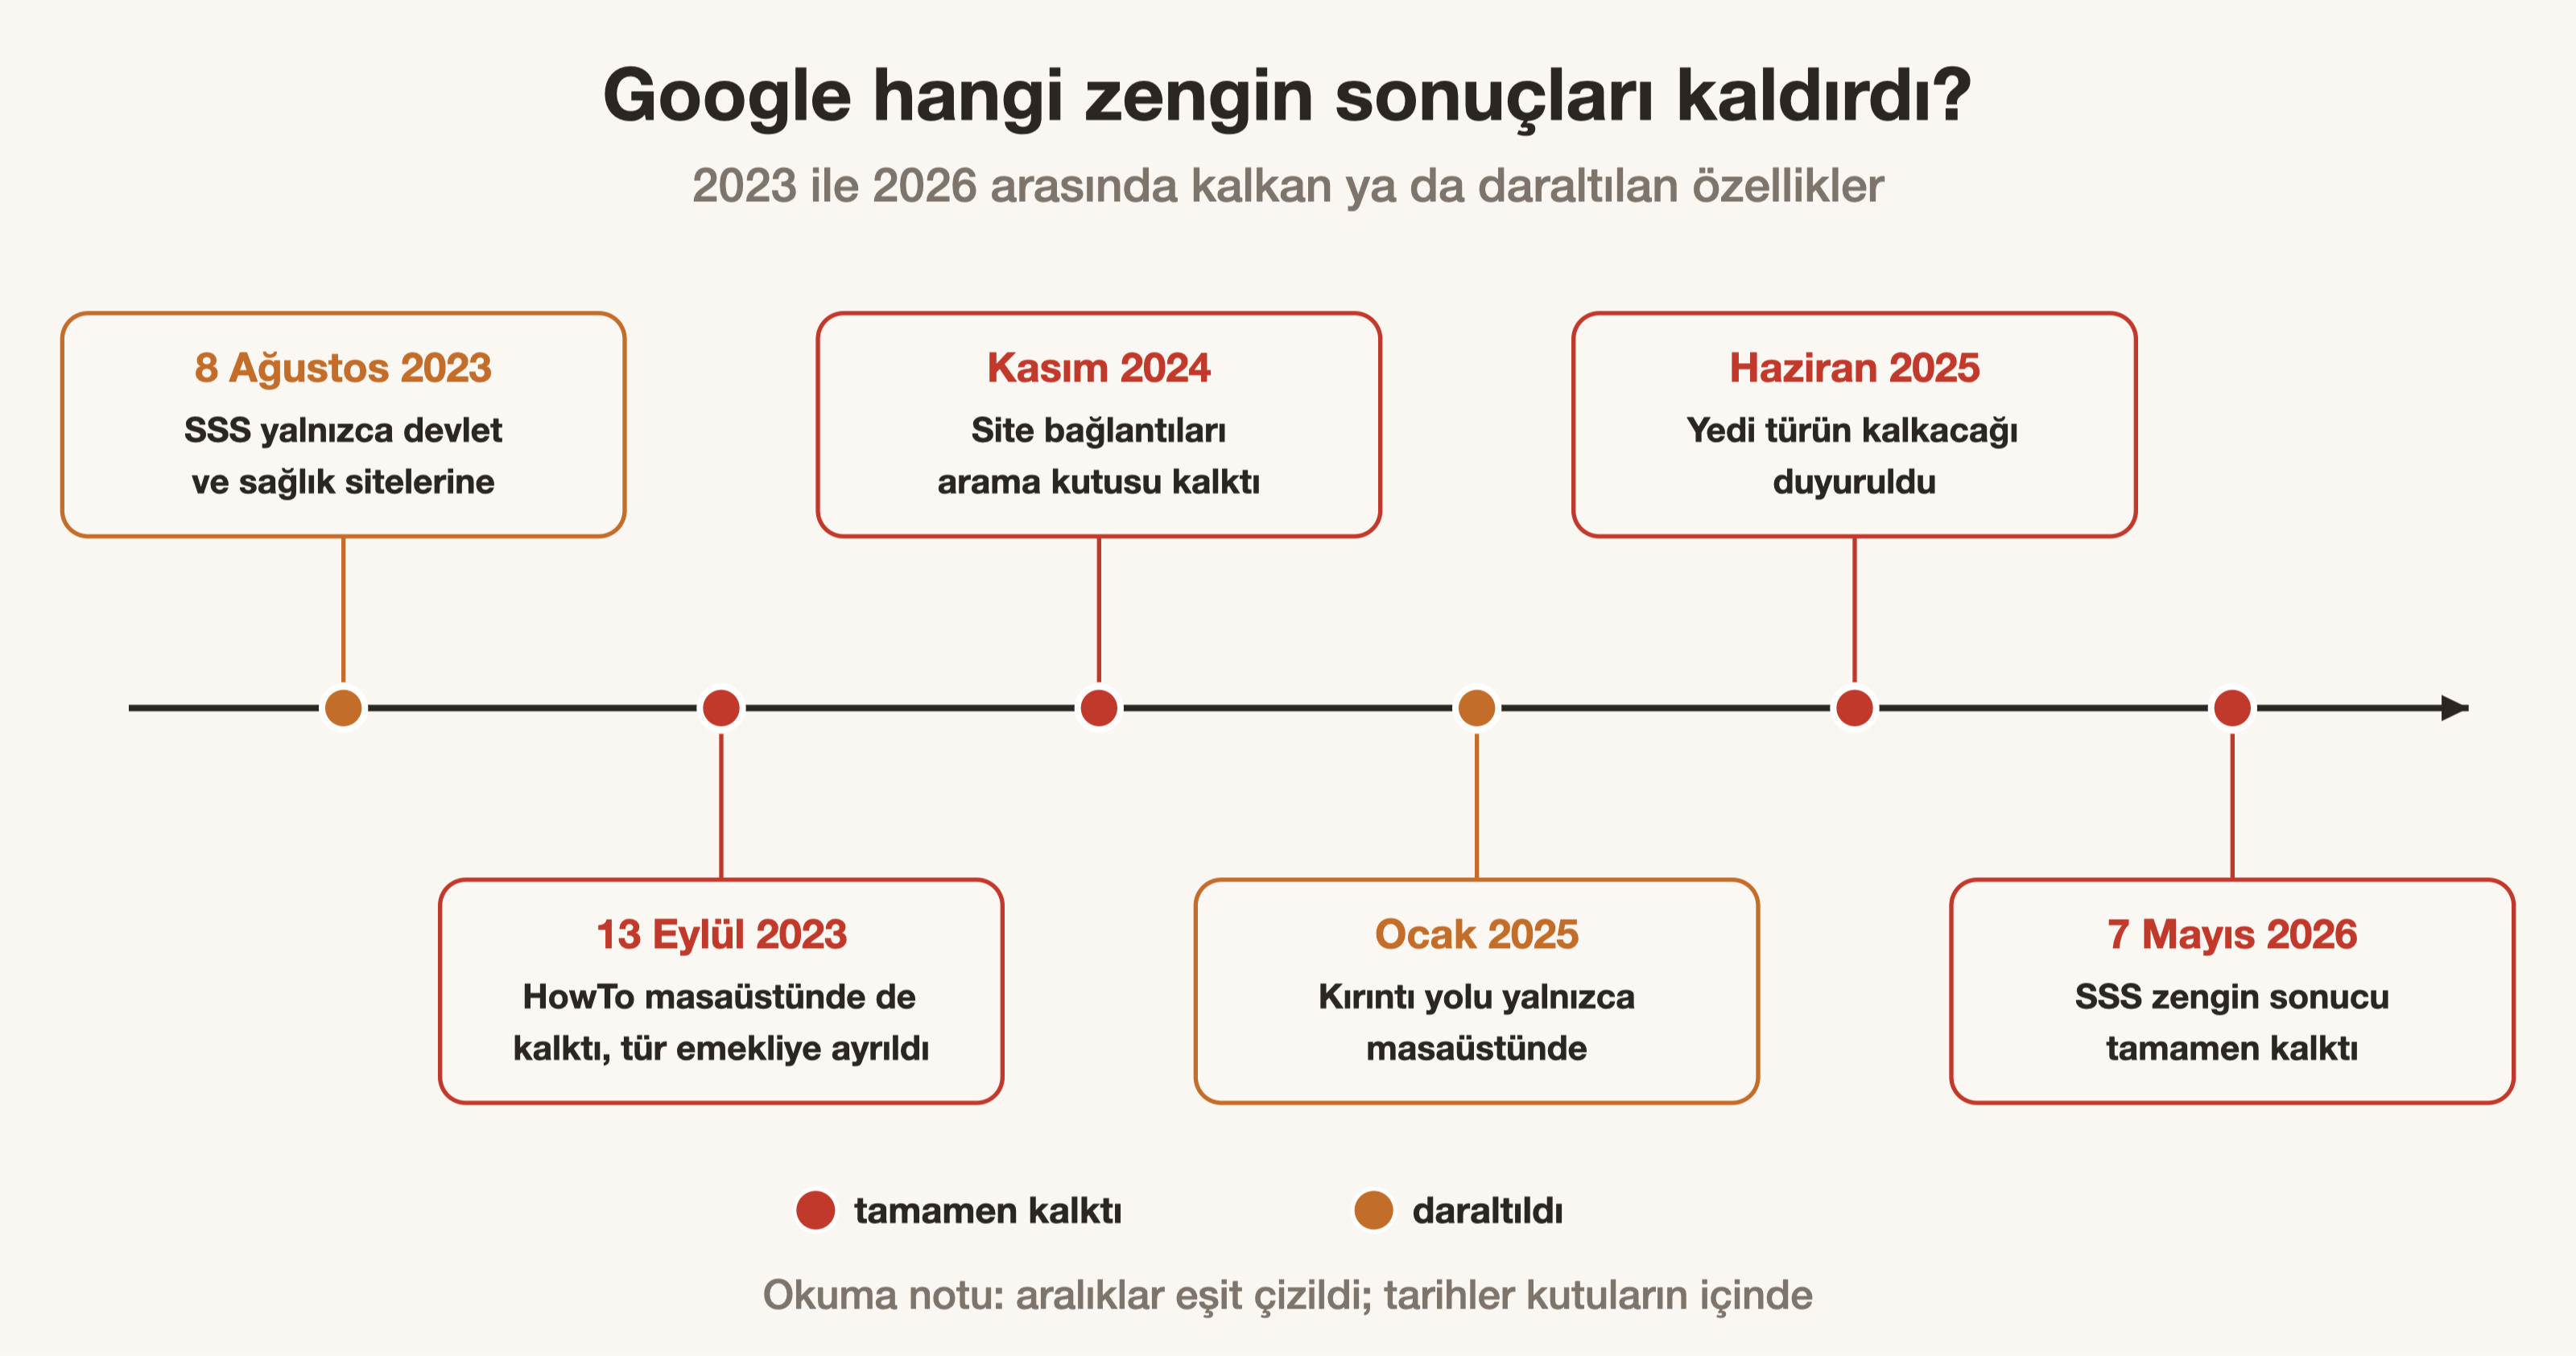
| BreadcrumbList | Sonuçta sayfanın site içindeki yolu | Ocak 2025'ten beri yalnızca masaüstünde |
| Organization | Logo, resmi ad, adres ve iletişim bilgisi | Kurum kimliğinin tek kaynağı |
| LocalBusiness | Çalışma saati, yol tarifi, puan | Fiziksel adresi olan işletmeler için |
| Product | Fiyat, stok ve puan | Ürün sayfaları için |
| Review snippet | Yıldız puanı ve yorum özeti | Gerçek kullanıcı yorumu şart |
| Event | Etkinlik listesi, tarih ve yer | Fiziksel mekânda, herkese açık etkinlik |
| VideoObject | Video önizlemesi ve bölümler | Sayfada gerçekten video olmalı |
| FAQPage | Gösterilmiyor | 7 Mayıs 2026'dan beri yok |
| HowTo | Gösterilmiyor | Eylül 2023'te kaldırıldı |
Yerel işletme işaretlemesini yerel SEO rehberimizde ayrıca anlattık. Ürün sayfalarındaki alanlar ise e-ticaret SEO yazımızın konusu. Burada ikisini tekrarlamıyoruz.
SSS ve HowTo zengin sonuçlarına ne oldu?
Google, 8 Ağustos 2023'te SSS zengin sonuçlarını iyi bilinen devlet ve sağlık siteleriyle sınırladı. HowTo önce mobilde, 13 Eylül 2023'te masaüstünde de kalktı. SSS zengin sonucu ise 7 Mayıs 2026'dan beri hiçbir sitede gösterilmiyor.
Kaldırılanlar bu ikisiyle sınırlı değil. Site bağlantıları arama kutusu Kasım 2024'te kalktı. Google, Haziran 2025'te birkaç türü daha emekliye ayırdı; aralarında kurs bilgisi ve tahmini maaş da var. Galeriyi ara ara yeniden okumak gerekiyor, çünkü liste değişiyor.
SSS şeması hâlâ yazılmalı mı?
Zengin sonuç için yazmanın bir karşılığı kalmadı. Google, 2023 duyurusunda kullanılmayan yapısal verinin sorun çıkarmadığını, sadece görünür etkisi olmadığını yazmıştı. Yani var olanı hemen silmek de gerekmiyor.
Bizim sitemizde soru-cevap bölümü olan sayfanın türüne FAQPage ekleniyor. Ayrı bir FAQPage düğümü açılmıyor, çünkü tek adres için iki sayfa düğümü oluşurdu. Sayfa türü bu durumda iki değer taşıyor: WebPage ve FAQPage. Soru ve cevaplar sayfada görünür olarak da duruyor.
Yapısal veri yapay zekâ aramasında işe yarıyor mu?
Google'a göre yapay zekâ özelliklerinde görünmek için yapısal veri şart değil. Bunun için eklenecek özel bir schema.org türü de yok. Yine de zengin sonuçlara uygunluk için kullanmaya devam etmeyi öneriyor.
Google'ın yapay zekâ rehberi tek bir uyarıyı öne çıkarıyor. Yapısal veri, sayfadaki görünür metinle eşleşmeli. Diğer yapay zekâ araçlarında kaynak olma işini GEO rehberimizde anlattık. Orada da tutarlı kurum bilgisi aynı rolü oynuyor.
Next.js ve WordPress'te nasıl eklenir?
Next.js'te JSON-LD, sayfa bileşeninde bir script etiketiyle basılır. WordPress'te çoğunlukla SEO eklentisi bu işi üstlenir. İki yolda da asıl risk, aynı bilginin iki farklı kaynaktan iki kez basılmasıdır.
Bizim sayfalarımız sunucu bileşeni olarak oluşturuluyor; JSON-LD bloğu sayfanın ilk HTML'inde geliyor. Google, JavaScript ile sonradan eklenen şemayı da okuyabiliyor. Yine de Google, sayfanın tarayıcıda oluşturulmasının her zaman garanti olmadığını yazıyor. İlk HTML'de gelen şema bu riske girmiyor. Yeni bir rota açıldığında kurum ve site düğümlerini ekleyen işlevin çağrılması gerekiyor (unutulursa o adreste kurum kimliği hiç görünmez).
Next.js sitemizde grafiği tek bir yardımcı işlev JSON'a çeviriyor. İşlev, metindeki küçüktür, büyüktür ve ve işaretlerini kaçış koduna çeviriyor. Bir ziyaretçi yorumunda "</script>" geçse bile etiket erkenden kapanmıyor. Yorumlar yapısal veriye girdiği için bu ayrıntı güvenlik açısından da gerekli.
WordPress'te sık karşılaşılan sorun yinelenen şemadır. SEO eklentisi bir kurum düğümü basar, tema ya da ikinci bir eklenti bir tane daha. İki düğümde adres farklıysa Google aynı işletmeyi iki farklı yerde görür. Kontrol için sayfa kaynağında "ld+json" aratıp blokları saymak yeterli.
Yapısal veri adım adım nasıl eklenir?
Önce sayfanın asıl konusu seçilir, sonra o türün Google belgesindeki zorunlu alanları doldurulur. Kod yayına çıkmadan iki araçla, çıktıktan sonra Search Console ile denetlenir. Sırayı bozmamak, sonradan çıkan hataların çoğunu önler.
- Sayfanın ana konusunu belirleyin: makale mi, hizmet mi, ürün mü?
- Google belgesinde o türün zorunlu ve önerilen alanlarını okuyun.
- Kurum ve site bilgisini tek bir kaynaktan üretin; her şablonda yeniden yazmayın.
- @id kuralını baştan koyun ve bütün düğümlerde aynı biçimi kullanın.
- JSON-LD'yi yazın ve yalnızca sayfada görünen bilgiyi işaretleyin.
- Rich Results Test ve Schema Markup Validator ile deneyin.
- Yayından sonra URL Denetleme aracında Google'ın şemayı bulduğunu doğrulayın.
Google, yapısal verinin hesabını görmek için basit bir öncesi ve sonrası testi öneriyor. Search Console'da birkaç aylık verisi olan, mevsimden etkilenmeyen sayfalar seçilir. Şema eklendikten sonra birkaç ay boyunca aynı sayfaların performansı adres filtresiyle izlenir. Google'ın paylaştığı bir örnekte, yapısal veri eklenen sayfaların tıklama oranı yüzde 25 yüksek ölçülmüş.
Rich Results Test ile Schema Markup Validator farkı ne?
Rich Results Test, Google'ın desteklediği türleri ve zengin sonuç uygunluğunu denetler. Schema Markup Validator ise schema.org sözlüğündeki bütün türlerin söz dizimine bakar. Biri Google'ın gözünden, diğeri standardın gözünden test eder.
| Konu | Rich Results Test | Schema Markup Validator |
|---|---|---|
| Kim işletiyor | schema.org topluluğu | |
| Neyi denetler | Google'ın desteklediği türler | schema.org'daki bütün türler |
| Zengin sonuç uygunluğu | Gösterir | Göstermez |
| Test yolu | Adres ya da kod | Adres ya da kod |
| Cihaz seçimi | Akıllı telefon varsayılan, masaüstü seçilebilir | Yok |
Validator, 2021'de eski Yapılandırılmış Veri Test Aracı'nın yerine geldi. Rich Results Test, robots.txt ya da noindex ile kapalı sayfayı denetleyemez. JSON-LD içindeki yorum satırlarını da görmezden geliyor. Standart ise yoruma izin vermiyor; yayına çıkmadan önce yorumları silmek gerekir. Canlıdaki durumu Search Console'un zengin sonuç raporları ve URL Denetleme aracı gösterir.
En sık hangi hatalar yapılıyor?
Hataların çoğu söz dizimi değil, anlam hatasıdır. Kod testten geçer ama yanlış bir şey söyler. İlk iki maddeyi kendi grafiğimizde bizzat düzelttik.
- Boşta kalan düğüm: yazar düğümü basılır ama hiçbir düğüm author ile ona bağlanmaz. Bizde bağ yalnızca makalelerde vardı; artık sayfa düğümünde de kuruluyor.
- about ile publisher karışıklığı: about sayfanın konusudur, yayıncı değil. Redis yazımızın konusu şirketimiz olmadığı için about yalnızca ana sayfada kaldı.
- Aynı adres için iki sayfa düğümü: ayrı FAQPage açmak yerine türü sayfa düğümüne ekledik.
- Sayfada görünmeyen veriyi işaretlemek: Google bunu yönergelerinde açıkça yasaklıyor.
- Uydurma değer: bilinmeyen görsel ölçüsü, var olmayan yorum ya da puan.
- Zorunlu alanı eksik bırakmak: o öğe zengin sonuca aday olmaz.
- Robots.txt ya da noindex ile kapalı sayfaya şema eklemek: Google o sayfayı okumaz.
Hepsini yakalamak için basit bir kural işe yarıyor. Grafikteki her @id ya bir yerden gösterilmeli ya da sayfanın kök düğümü olmalı. Kurulumdan sonraki teknik denetim adımları için SEO teknik kontrol listesi sayfamıza bakabilirsiniz. Grafiği sitenizle birlikte kurmamızı isterseniz SEO yönetimi hizmetimizi inceleyin.
Sıkça sorulan sorular
- Schema markup nedir?
- Schema markup, sayfanın neyi anlattığını schema.org sözlüğüyle arama motorlarına bildiren koddur. Ziyaretçi görmez, arama motoru okur.
- Hangi biçim kullanılmalı?
- Google JSON-LD, Microdata ve RDFa'yı kabul ediyor. Bakımı en kolay olduğu için JSON-LD'yi öneriyor.
- @Graph ne işe yarar?
- @Graph, sayfadaki bütün düğümleri tek listede toplar. Düğümler birbirine @id değerleriyle bağlanır ve kurum bilgisi bir kez yazılır.
- SSS şeması hâlâ zengin sonuç verir mi?
- Hayır. SSS zengin sonucu 7 Mayıs 2026'dan beri Google'da gösterilmiyor. Kullanılmayan yapısal veri ise sorun çıkarmıyor.
- HowTo şeması ne zaman kalktı?
- HowTo önce mobilde kaldırıldı. 13 Eylül 2023'te masaüstünde de gösterilmez oldu.
- Yapay zekâ aramasında görünmek için şema gerekli mi?
- Google'a göre gerekli değil ve özel bir schema.org türü de yok. Yine de zengin sonuçlar için kullanılması öneriliyor.
- Rich Results Test ile Schema Markup Validator arasındaki fark ne?
- Rich Results Test, Google'ın desteklediği türleri ve zengin sonuç uygunluğunu denetler. Validator ise schema.org'daki bütün türlerin söz dizimine bakar.
- Yapısal veri sıralamayı etkiler mi?
- Google zengin sonucu garanti etmiyor. Yapısal veri ihlalinde gelen elle işlem de yalnızca zengin sonuç hakkını kaldırıyor, sıralamayı etkilemiyor.
Kaynakça
- Yapılandırılmış Veri İşaretlemenin Nasıl Çalıştığına Giriş — Üç biçimi, JSON-LD önerisini ve görünmeyen bilginin işaretlenmemesi gerektiğini destekler.
- Genel yapılandırılmış veri yönergeleri — Zengin sonucun garanti olmadığını, elle işlemi ve öğeleri @id ile bağlamayı açıklar.
- Google Arama'nın Desteklediği Yapılandırılmış Veri İşaretleme — Tür tablosundaki zengin sonuç karşılıklarının güncel listesidir.
- Nasıl yapılır? ve SSS zengin sonuçlarındaki değişiklikler — 2023'teki SSS kısıtını, HowTo'nun kalkmasını ve kullanılmayan verinin zararsız olduğunu destekler.
- Son Google Arama Doküman Güncellemeleri — SSS zengin sonucunun 7 Mayıs 2026'da kalktığını ve kırıntı yolunun masaüstüne çekildiğini gösterir.
- Yapılandırılmış Veri Test Aracı güncellemesi — Rich Results Test ile Schema Markup Validator arasındaki görev ayrımını açıklar.